


Cómo redactar el método de análisis de datos de tu tesis
Útil  Mike Taylor 30 sep. 2026 Tiempo de lectura ≈ 14 min
El método de análisis de datos le dice al jurado qué prueba responde cada pregunta de tu problema de investigación. Si la correspondencia es correcta, el apartado cabe en media página. Si no lo es, los resultados se apoyan en una prueba que no responde lo que preguntaste.
El apartado suele cerrar la metodología, después de la población y muestra, las técnicas e instrumentos de recolección y el procedimiento. Esta guía cubre qué lleva, cómo se calculan la media de un ítem de Likert y los baremos, qué prueba corresponde a cada pregunta y cómo se ve una versión terminada.
Qué es el método de análisis de datos
Es la lista de las pruebas estadísticas que vas a usar, con tres datos de cada una: qué es, qué pregunta de tu problema de investigación responde y cómo se calcula. Según la universidad se titula Método de análisis de datos, Técnicas de procesamiento y análisis de datos o Análisis estadístico. El contenido es el mismo.
Dos cosas más van aquí. El nivel de significancia, casi siempre 0,05, declarado una sola vez para todas las pruebas. Y el programa, sea Excel, SPSS o uno gratuito como jamovi. El proyecto se escribe en futuro («se utilizará») y la tesis final en pasado.
La forma más rápida de armarlo es leer el problema de investigación pregunta por pregunta. Cada pregunta necesita exactamente una prueba, y cada prueba que nombres necesita una pregunta. Una prueba sin pregunta es relleno, y el jurado bien puede preguntar qué hace ahí.
Relaciona cada pregunta con una prueba
Las preguntas de investigación son de tres tipos. Unas piden describir algo, como el perfil de los participantes o su nivel de satisfacción. Otras piden comparar grupos, como hombres y mujeres. Otras preguntan si dos cosas están relacionadas, como la gestión del tiempo y el rendimiento académico. El tipo de pregunta decide la prueba. El tipo de dato decide la variante.
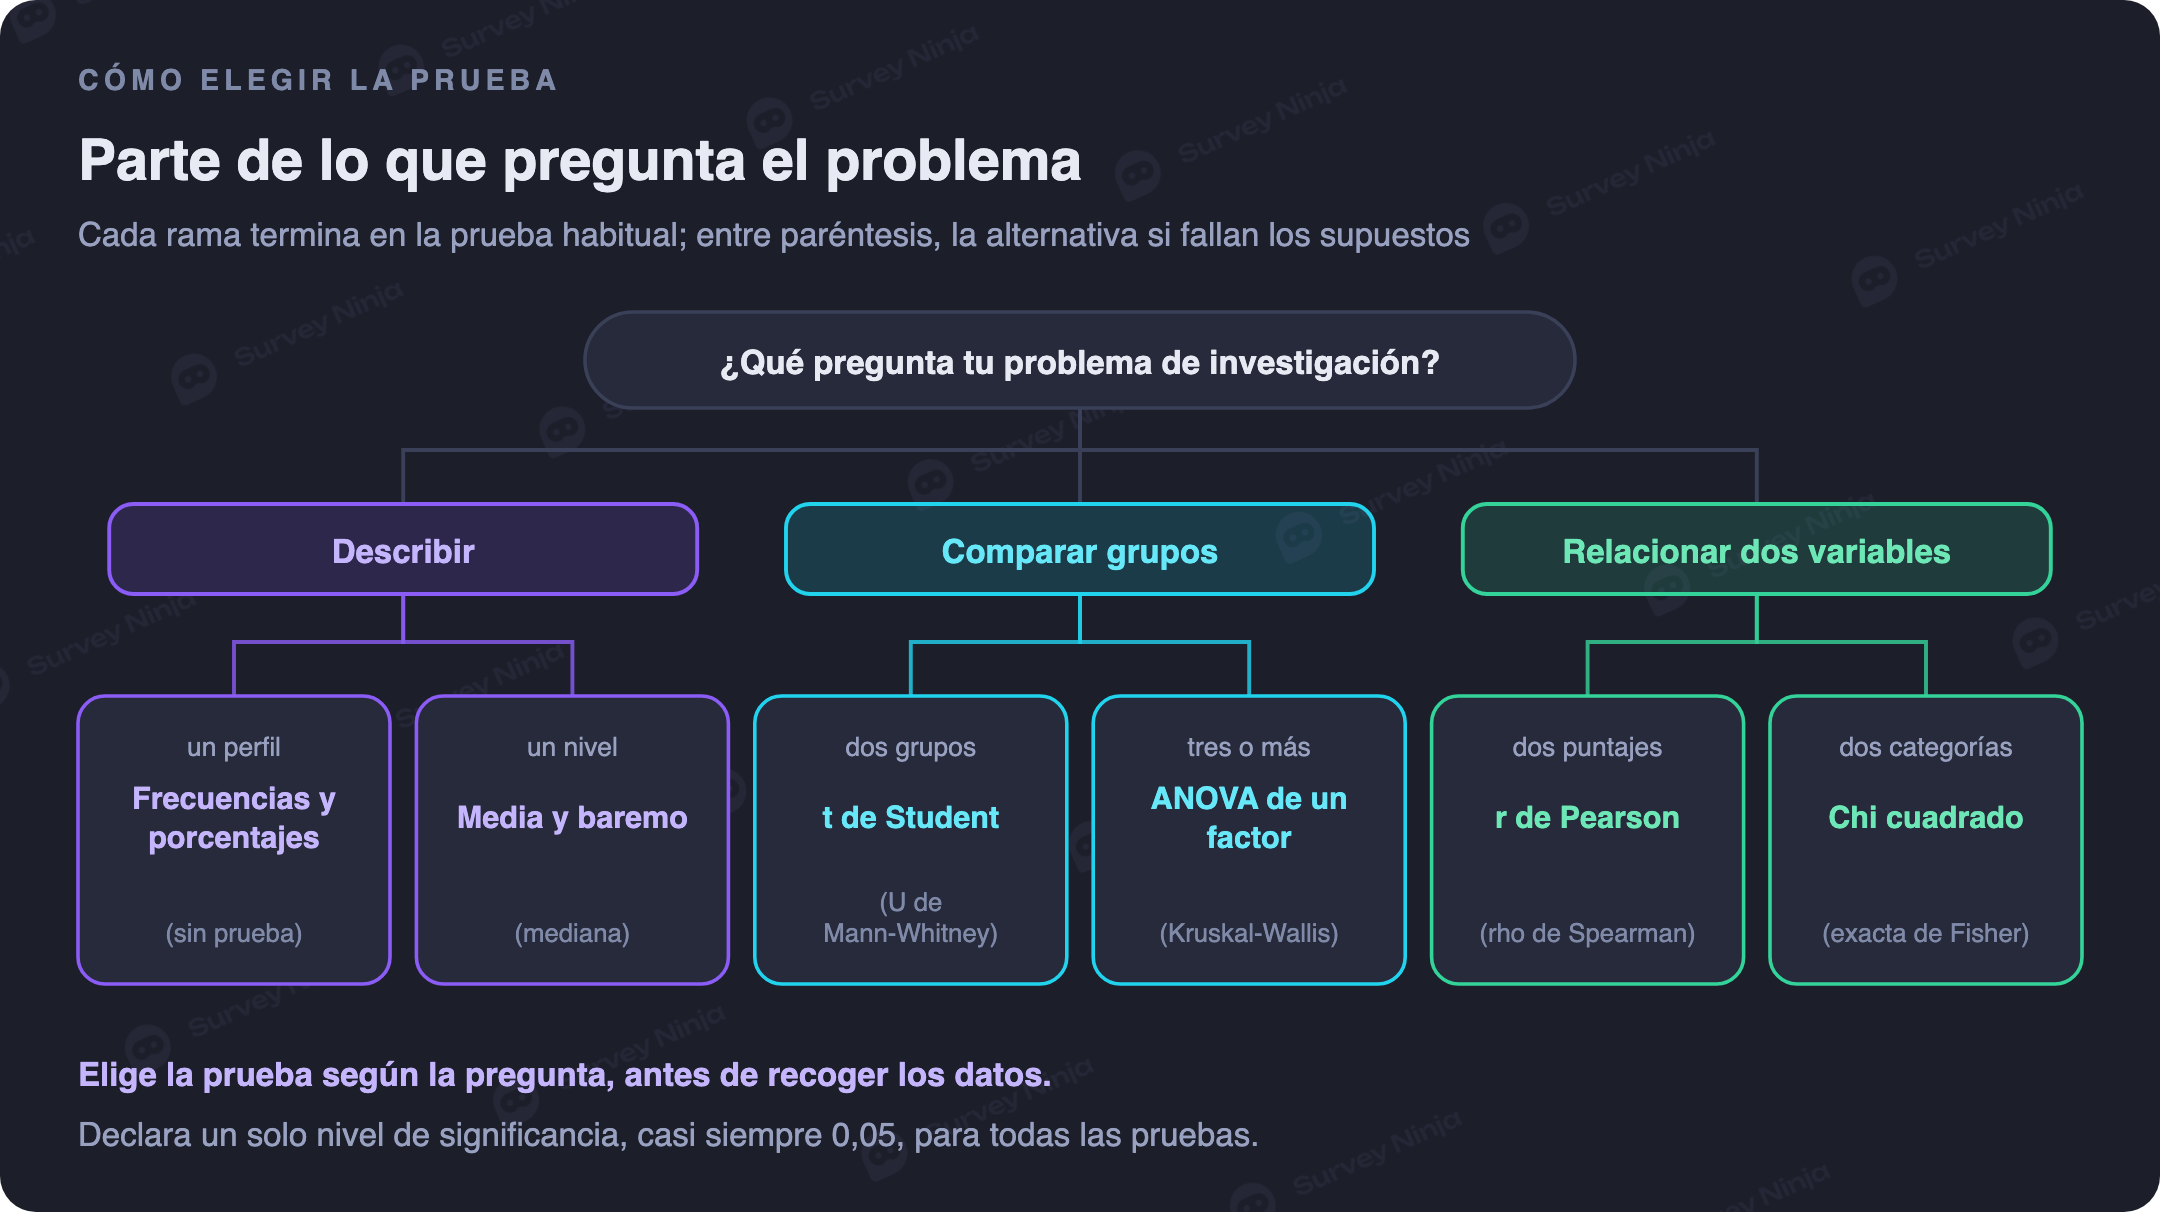
El mismo mapa como tabla, con la alternativa para cuando no se cumplen los supuestos de la prueba:
| La pregunta pide | Ejemplo | Prueba habitual | Si fallan los supuestos |
|---|---|---|---|
| Un perfil | ¿Cuál es el perfil de los participantes según sexo y escuela profesional? | Frecuencias y porcentajes | No hace falta |
| Un nivel | ¿Cuál es el nivel de satisfacción con la educación virtual? | Media con escala de interpretación o baremo | Mediana |
| Diferencia, dos grupos | ¿Existen diferencias significativas entre hombres y mujeres? | t de Student para muestras independientes | U de Mann-Whitney |
| Diferencia, tres grupos o más | ¿Existen diferencias entre Administración, Contabilidad y Economía? | ANOVA de un factor | Kruskal-Wallis |
| Relación, dos puntajes | ¿Existe relación entre la gestión del tiempo y el rendimiento académico? | r de Pearson | Rho de Spearman |
| Asociación, dos categorías | ¿Está asociado el turno con la modalidad de estudio preferida? | Chi cuadrado de independencia | Prueba exacta de Fisher, con frecuencias pequeñas |
Frecuencias y porcentajes
La primera pregunta de casi todo problema de investigación pide el perfil de los participantes, y la herramienta es la más sencilla: contar cada categoría y convertir el conteo en proporción.
P = (f / n) × 100
Aquí f es la frecuencia de una categoría y n el número de participantes. Si 108 de 188 participantes son mujeres, P = 108 / 188 × 100 = 57,4%. Redondea a un decimal y comprueba que cada variable sume 100,0. La tabla con el perfil va en el capítulo de resultados.
Media, escala de interpretación y baremos
Para preguntas sobre un nivel medido con una escala de Likert se usa la media del ítem, a veces llamada media ponderada. Cada respuesta tiene un peso, de 5 para totalmente de acuerdo a 1 para totalmente en desacuerdo, y la media es la suma de frecuencia por peso dividida entre el número de participantes:
Media = Σ(f × p) / n
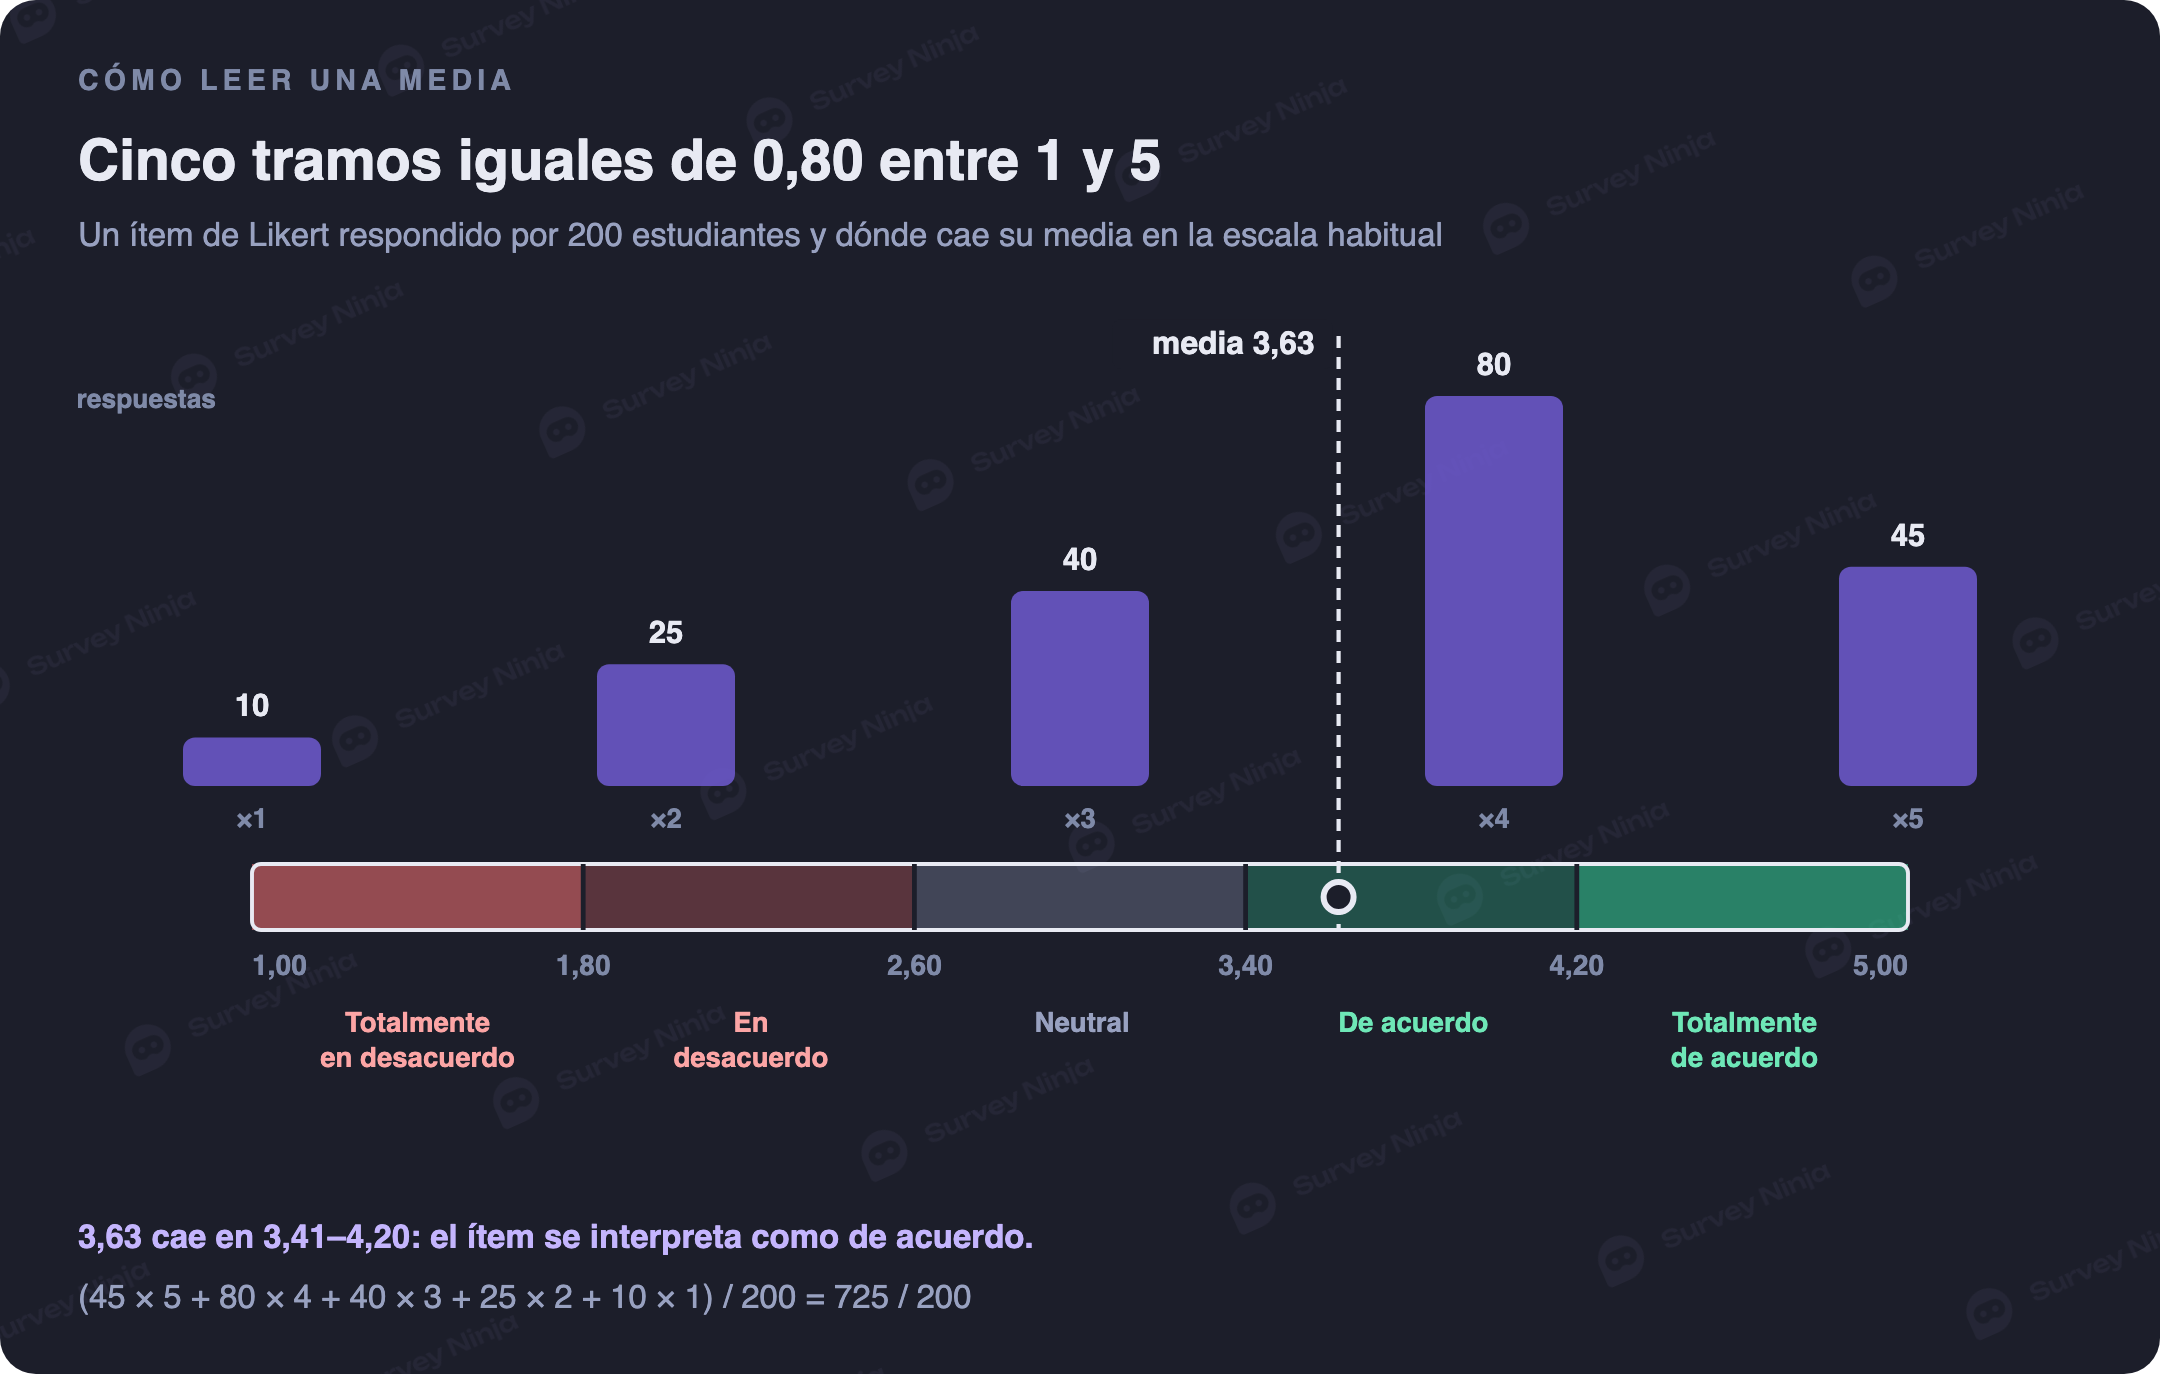
Un ítem respondido por 200 estudiantes: 45 totalmente de acuerdo, 80 de acuerdo, 40 neutral, 25 en desacuerdo y 10 totalmente en desacuerdo. La media es (45 × 5 + 80 × 4 + 40 × 3 + 25 × 2 + 10 × 1) / 200 = 725 / 200 = 3,63. Es la media de siempre de las respuestas codificadas, calculada desde una tabla de frecuencias.
El número dice poco hasta leerlo en una escala de interpretación. La habitual corta la distancia de 1 a 5 en cinco tramos iguales. El rango es 5 − 1 = 4. Dividido entre cinco categorías, da tramos de 0,80:
| Media | Interpretación |
|---|---|
| 4,21–5,00 | Totalmente de acuerdo |
| 3,41–4,20 | De acuerdo |
| 2,61–3,40 | Neutral |
| 1,81–2,60 | En desacuerdo |
| 1,00–1,80 | Totalmente en desacuerdo |
Así, 3,63 se lee como de acuerdo. En una escala de 4 puntos el tramo es 3 / 4 = 0,75, con 1,00–1,75, 1,76–2,50, 2,51–3,25 y 3,26–4,00.
Muchas tesis no interpretan ítem por ítem sino la variable completa, con un baremo. Si la variable tiene 10 ítems de 1 a 5, cada participante suma entre 10 y 50 puntos. Con tres niveles de igual amplitud, 40 / 3 ≈ 13,3, el baremo queda en bajo de 10 a 23, medio de 24 a 36 y alto de 37 a 50. La lógica es la misma que la de la escala de interpretación: tramos iguales y explicados.
Ten presente lo que la media no hace: describe, no prueba. «El nivel de satisfacción es alto» es una descripción. «Hombres y mujeres difieren» es una afirmación que necesita una prueba. Cuando las respuestas se amontonan en los dos extremos, una media de 3 esconde una división, y nuestra guía de análisis descriptivo muestra cuándo la mediana cuenta mejor la historia. Si todavía estás armando el cuestionario, la guía de la escala de Likert cubre etiquetas, número de puntos e ítems invertidos.
¿Se puede usar t de Student con datos de Likert?
Una lectura estricta dice que no. Las respuestas de Likert son ordinales, la distancia entre de acuerdo y totalmente de acuerdo no se conoce, así que la media y las pruebas paramétricas no deberían aplicarse. En la práctica la cuestión se resolvió de otro modo. Norman (2010), en Advances in Health Sciences Education, revisó estudios desde los años treinta y mostró que la t de Student, el ANOVA y el r de Pearson son robustos frente a esas violaciones: con datos de Likert rara vez dan una respuesta equivocada.
De ahí sale una regla práctica. Si promedias o sumas varios ítems en un puntaje por participante, las pruebas paramétricas sirven. Si pruebas un solo ítem, o los puntajes están claramente sesgados, usa la alternativa de la tabla. Para revisar la distribución, muchas tesis aplican Kolmogorov-Smirnov con más de 50 casos y Shapiro-Wilk con menos. Razali y Wah (2011) compararon las pruebas de normalidad habituales y Shapiro-Wilk resultó la más potente, así que es una buena elección también con muestras grandes. Sea cual sea la regla, escríbela antes de ver los resultados.
Diferencias: t de Student y ANOVA
La t de Student para muestras independientes compara las medias de dos grupos, como hombres y mujeres. Con tres grupos o más, como tres escuelas profesionales, usa un ANOVA de un factor en lugar de varias t de Student, porque cada prueba adicional aumenta la probabilidad de un falso positivo. Si el ANOVA encuentra una diferencia significativa, una prueba post hoc como la de Tukey dice qué grupos difieren.
Estas preguntas suelen plantearse con una hipótesis nula: «No existen diferencias significativas en el nivel de satisfacción entre hombres y mujeres». La regla de decisión también va en el apartado. Si el valor p es menor que 0,05, se rechaza la hipótesis nula. Nuestra entrada del glosario sobre la significancia estadística explica lo que el valor p dice y lo que no.
Relaciones: Pearson, Spearman y chi cuadrado
El r de Pearson mide la relación lineal entre dos puntajes, de −1 a +1. Cohen (1988) propuso 0,10, 0,30 y 0,50 como efecto pequeño, mediano y grande, y la tesis informa el coeficiente junto con su valor p. Cuando los puntajes no siguen una distribución normal, o son ordinales, se usa el Rho de Spearman, muy usado en las tesis correlacionales. Nuestra calculadora de correlación de Pearson devuelve r, r² y el valor p a partir de dos columnas de datos. Nuestra guía de correlación en encuestas explica por qué ni un r significativo demuestra que una cosa cause la otra.
Cuando las dos variables son categorías, como el turno y la modalidad preferida, la prueba es el chi cuadrado de independencia. Compara las frecuencias observadas en una tabla cruzada con las que se esperarían si las variables no estuvieran relacionadas. La regla práctica pide una frecuencia esperada de al menos 5 en la mayoría de las celdas. Con menos, usa la prueba exacta de Fisher. Nuestra calculadora de chi cuadrado acepta tablas de 2×2 y mayores.
Confiabilidad, nivel de significancia y programa
Si el instrumento es un conjunto de ítems de Likert, el jurado también preguntará si es confiable. Eso suele informarse en el apartado del instrumento, a partir de la prueba piloto, con el alfa de Cronbach. Algunas plantillas piden repetirlo aquí. Sigue la plantilla de tu universidad.
Declara el nivel de significancia una vez: «Todas las pruebas se trabajarán con un nivel de significancia de 0,05». Nombra el programa y su versión. SPSS es el habitual en muchas universidades. Excel con el complemento Herramientas para análisis cubre frecuencias, medias, t de Student, ANOVA de un factor y correlación. Los programas gratuitos jamovi y JASP añaden pruebas post hoc, pruebas no paramétricas y Shapiro-Wilk en pocos clics.
Los datos pueden salir directo de la encuesta. Puedes armar el cuestionario gratis en SurveyNinja y exportar las respuestas a Excel, una columna por pregunta, listas para codificar.
Modelo de método de análisis de datos
Este es un ejemplo completo para un estudio descriptivo correlacional, escrito para el proyecto de tesis. Reemplaza los datos entre corchetes y conserva una prueba por pregunta.
Los datos se procesarán en Microsoft Excel y SPSS [versión], con un nivel de significancia de 0,05 para todas las pruebas.
1. Se usarán frecuencias y porcentajes para describir el perfil de los participantes según sexo y escuela profesional, con P = (f / n) × 100.
2. El nivel de cada variable se describirá con la media y la desviación estándar, y se clasificará en bajo, medio y alto según un baremo de tres tramos de igual amplitud.
3. La normalidad de los puntajes se evaluará con la prueba de Shapiro-Wilk. Si los puntajes siguen una distribución normal, la relación entre [variable 1] y [variable 2] se determinará con el r de Pearson; si no, con el Rho de Spearman.
4. Para comparar el nivel de [variable 1] entre hombres y mujeres se usará la t de Student para muestras independientes o, si no se cumple la normalidad, la U de Mann-Whitney.
En la tesis final el mismo texto pasa a pasado y nombra la versión del programa que realmente se usó.
Errores frecuentes en el análisis de datos
- Una prueba nombrada sin ninguna pregunta del problema que responder.
- La media usada para afirmar una diferencia significativa. Describe, no prueba.
- Varias t de Student donde hacía falta un ANOVA.
- Pearson usado con dos categorías, o chi cuadrado con dos puntajes.
- Un baremo o una escala de interpretación sin explicar de dónde salen los tramos.
- «Significativo» escrito sin valor p ni nivel de significancia.
- Fórmulas copiadas sin decir qué significa cada símbolo.
El método de análisis de datos es la última promesa de la metodología. El capítulo de resultados la cumple, pregunta por pregunta y en el mismo orden.
Preguntas frecuentes
¿Qué es el método de análisis de datos en una tesis?
Es la parte de la metodología que nombra cada prueba estadística del estudio, la pregunta de investigación que responde, su fórmula y el nivel de significancia, casi siempre 0,05.
¿Cómo se redacta el método de análisis de datos?
Recorre el problema de investigación pregunta por pregunta y asigna una prueba a cada una: frecuencias y porcentajes para el perfil, la media o un baremo para los niveles, t de Student o ANOVA para las diferencias, Pearson, Spearman o chi cuadrado para las relaciones. Luego agrega el nivel de significancia y el programa.
¿Cuál es la fórmula de la media de un ítem de Likert?
Media = Σ(f × p) / n, donde f es el número de participantes que eligió una respuesta, p su peso, de 5 para totalmente de acuerdo a 1 para totalmente en desacuerdo, y n el total de participantes.
¿Qué significa una media de 3,41 a 4,20?
En la escala de interpretación habitual de 5 puntos significa de acuerdo. La escala divide el rango de 1 a 5 en cinco tramos iguales de 0,80, así que 4,21 a 5,00 es totalmente de acuerdo y 3,41 a 4,20 es de acuerdo.
¿t de Student o ANOVA?
t de Student para dos grupos, ANOVA de un factor para tres o más. Hacer varias t de Student en lugar de un ANOVA aumenta la probabilidad de un falso positivo.
¿Pearson o Spearman?
Pearson cuando los dos puntajes son numéricos y siguen una distribución aproximadamente normal. Spearman cuando son ordinales, están sesgados o la relación no es lineal pero sí creciente o decreciente.
Publicado: 30 sep. 2026