Limitações do Google Forms: limite de respostas, upload, timer e lógica, com soluções
Bots em pesquisas: como identificar e evitar respostas fraudulentas e geradas por IA
Criação de pesquisas  Mike Taylor 16 nov 2026 Tempo de leitura ≈ 20 min
Conteúdo
- De onde vêm as respostas fraudulentas em pesquisas
- O que mudou com os agentes de IA
- Lista em camadas contra bots em pesquisas
- Antes do campo: controle quem pode entrar
- Dentro da pesquisa: checagens que ainda funcionam
- Depois da coleta: sinais nos dados
- Escreva a regra de limpeza antes do campo
- Como proteger uma pesquisa no SurveyNinja
- Perguntas frequentes
Bots em pesquisas são scripts e agentes de IA que preenchem questionários online, quase sempre para ganhar um incentivo. Junto com pessoas que respondem correndo ou mais de uma vez, eles geram respostas fraudulentas em pesquisas que parecem dados reais. Nenhuma checagem pega todos, então este guia traz uma lista em camadas: de onde vem o risco, o que preparar antes do campo, quais checagens colocar dentro da pesquisa e como limpar os dados com regras escritas antes.
A abordagem é metodológica e vale para qualquer ferramenta de pesquisa. O conceito e os principais tipos de fraude estão no nosso glossário, no verbete sobre detecção de fraude.
Pontos principais
- As respostas falsas se concentram onde há um link aberto, uma recompensa que vale a pena e uma amostra aberta, e tirar uma das três diminui o problema.
- Num estudo publicado na PNAS em 2025, um agente de IA passou em 99,8% das perguntas de atenção padrão, então passar nelas já não prova que uma pessoa respondeu.
- Distribua por canais fechados com links únicos, permita uma resposta por pessoa e deixe incentivos fora dos posts abertos.
- Defina os critérios de exclusão antes do campo e combine vários sinais, como tempos muito baixos, respostas em linha reta e respostas abertas duplicadas.
De onde vêm as respostas fraudulentas em pesquisas
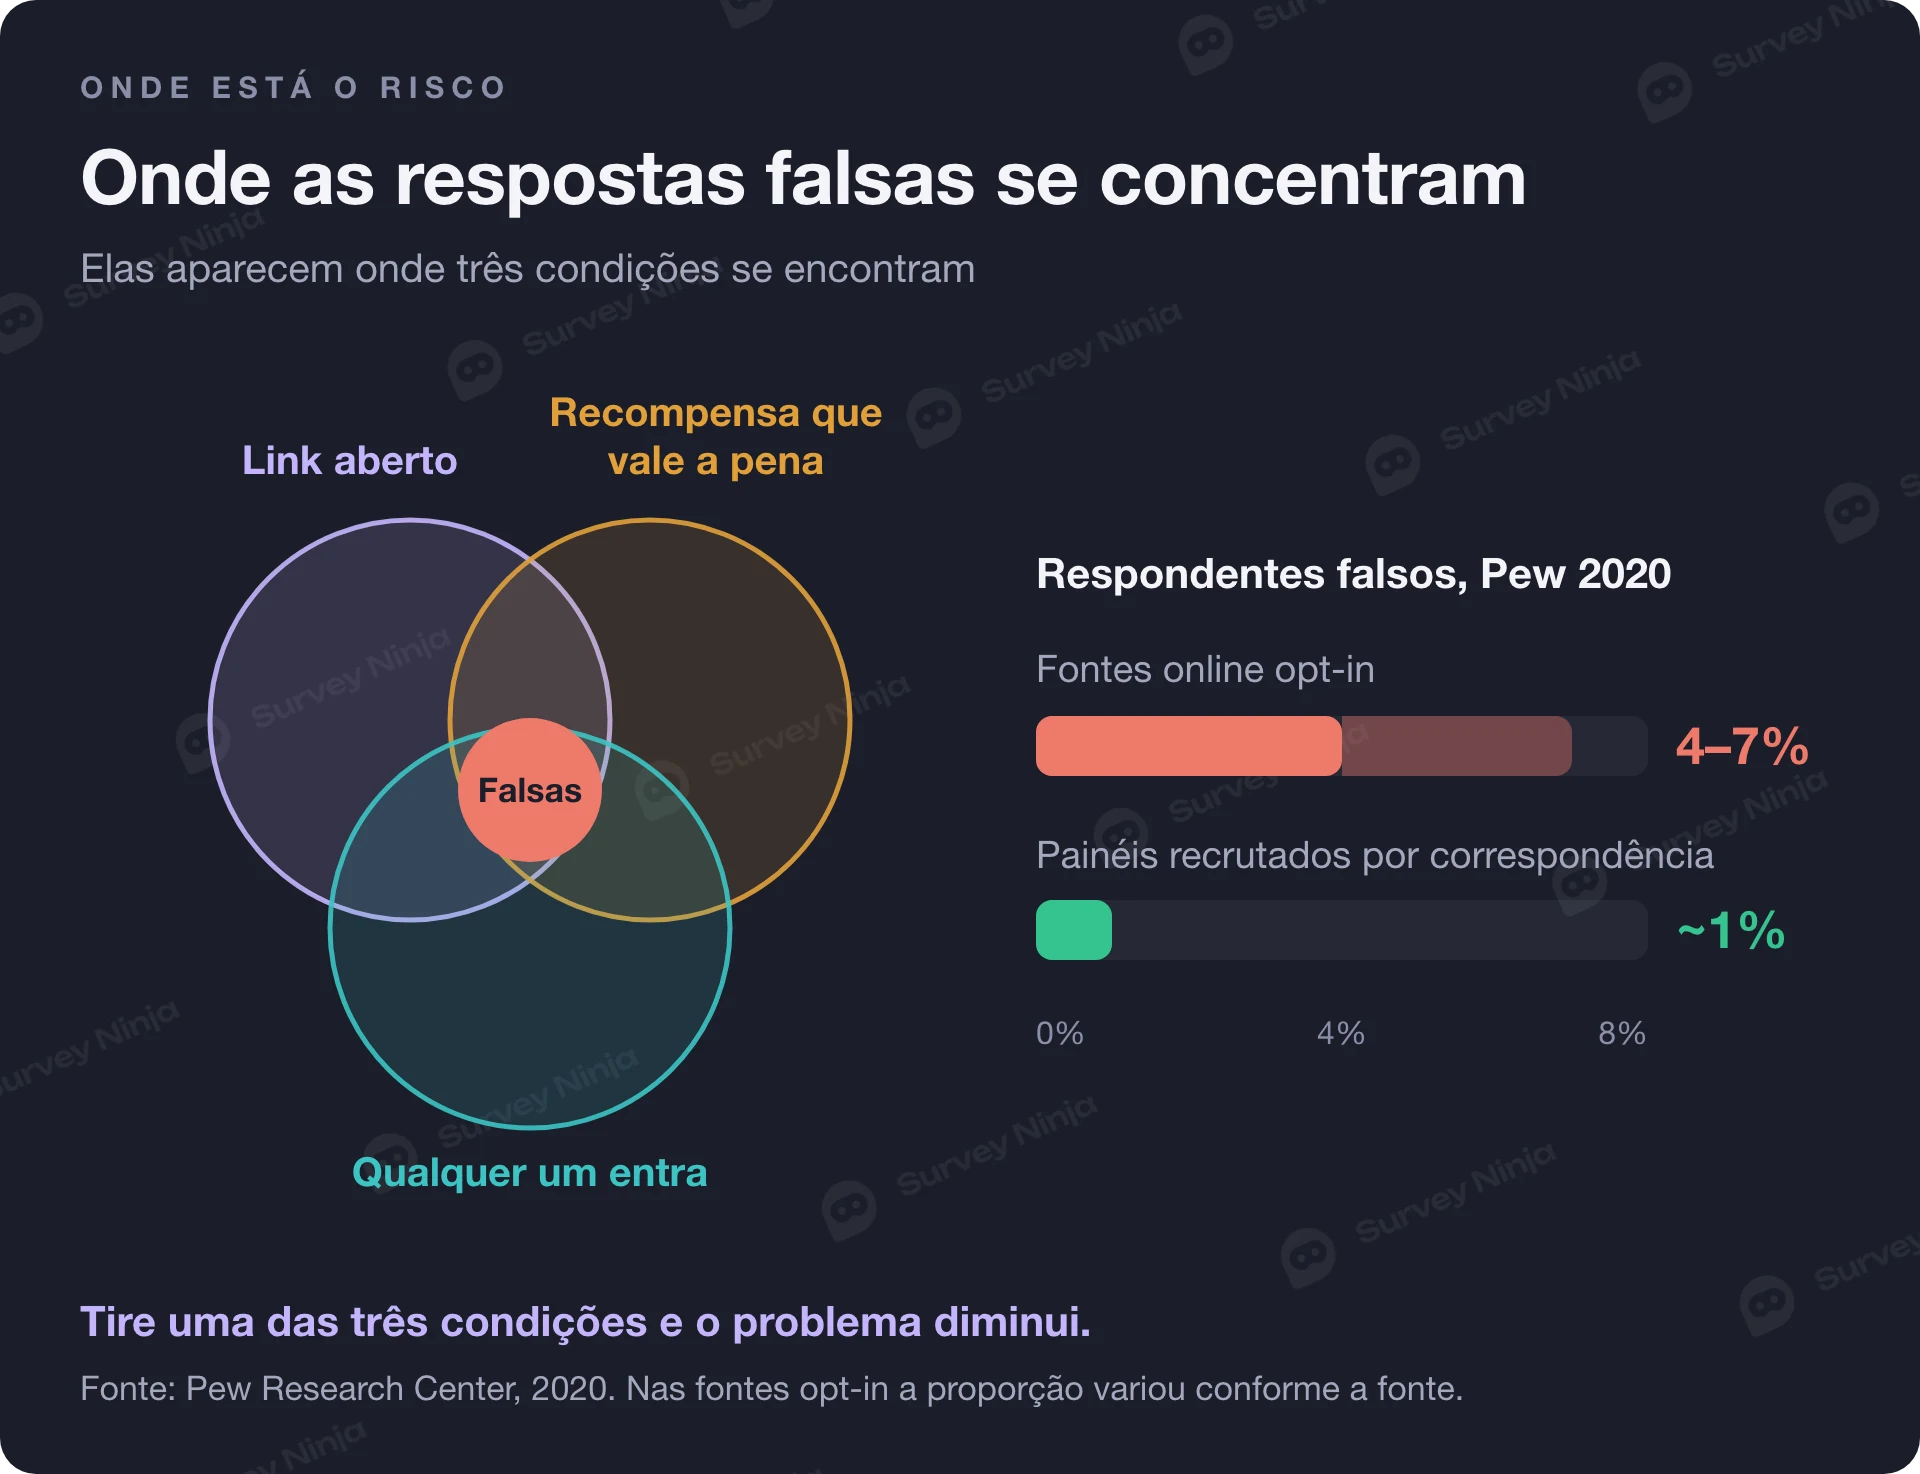
As respostas falsas se concentram onde três coisas se encontram: um link que qualquer um abre, uma recompensa que vale a pena e uma amostra em que qualquer um entra. Tire uma das três e o problema diminui.
O Pew Research Center mediu isso no relatório de 2020 Assessing the Risks to Online Polls From Bogus Respondents. As fontes online de adesão voluntária (opt-in) tinham de 4% a 7% de respondentes falsos, conforme a fonte, enquanto dois painéis recrutados por correspondência a partir de endereços tinham cerca de 1%. Os falsos tendiam a escolher respostas positivas, o que empurrava números como a aprovação de governo para um lado. As defesas padrão ajudaram pouco: 84% dos respondentes falsos passaram na pergunta de atenção e 87% passaram no controle de velocidade.
| De onde vem o risco | Por que atrai respostas falsas | Primeira defesa |
|---|---|---|
| Link aberto postado em redes sociais, fóruns ou grupos de promoções | Scripts e caçadores de prêmios acham links públicos rápido, e uma pessoa pode responder várias vezes | Distribuir por canais fechados: sua base de clientes, uma área de membros, links únicos |
| Incentivo visível num post aberto | Vale-presente ou sorteio transforma a pesquisa em alvo | Falar do prêmio só para quem foi convidado e pagar depois de checar a resposta |
| Painéis opt-in e sites de microtarefas | Qualquer um se cadastra, e alguns membros respondem principalmente pelo pagamento | Perguntas de triagem, controles de qualidade combinados com o fornecedor e folga para limpeza no orçamento |
| Questionário longo ou repetitivo | Pessoas reais cansam e começam a correr ou a marcar sempre a mesma coisa | Pesquisa mais curta, menos matrizes, um tema por página |
| Link repassado para fora do público-alvo | Gente fora da sua população responde de boa-fé | Pergunta de triagem com desqualificação e senha para grupos fechados |
O desenho da amostra pesa tanto quanto qualquer checagem. Amostras em que qualquer um se oferece, como a amostragem por conveniência, são as mais fáceis de infiltrar. Desenhos em que você escolhe quem convidar, explicados no nosso guia de amostragem probabilística, deixam bem menos portas abertas. Se ainda está decidindo onde recrutar, veja onde encontrar respondentes.
O que mudou com os agentes de IA
Os bots clássicos eram scripts que clicavam ao acaso ou davam a mesma resposta em tudo. Eram baratos e relativamente fáceis de pegar. Os modelos de linguagem mudaram as duas coisas.
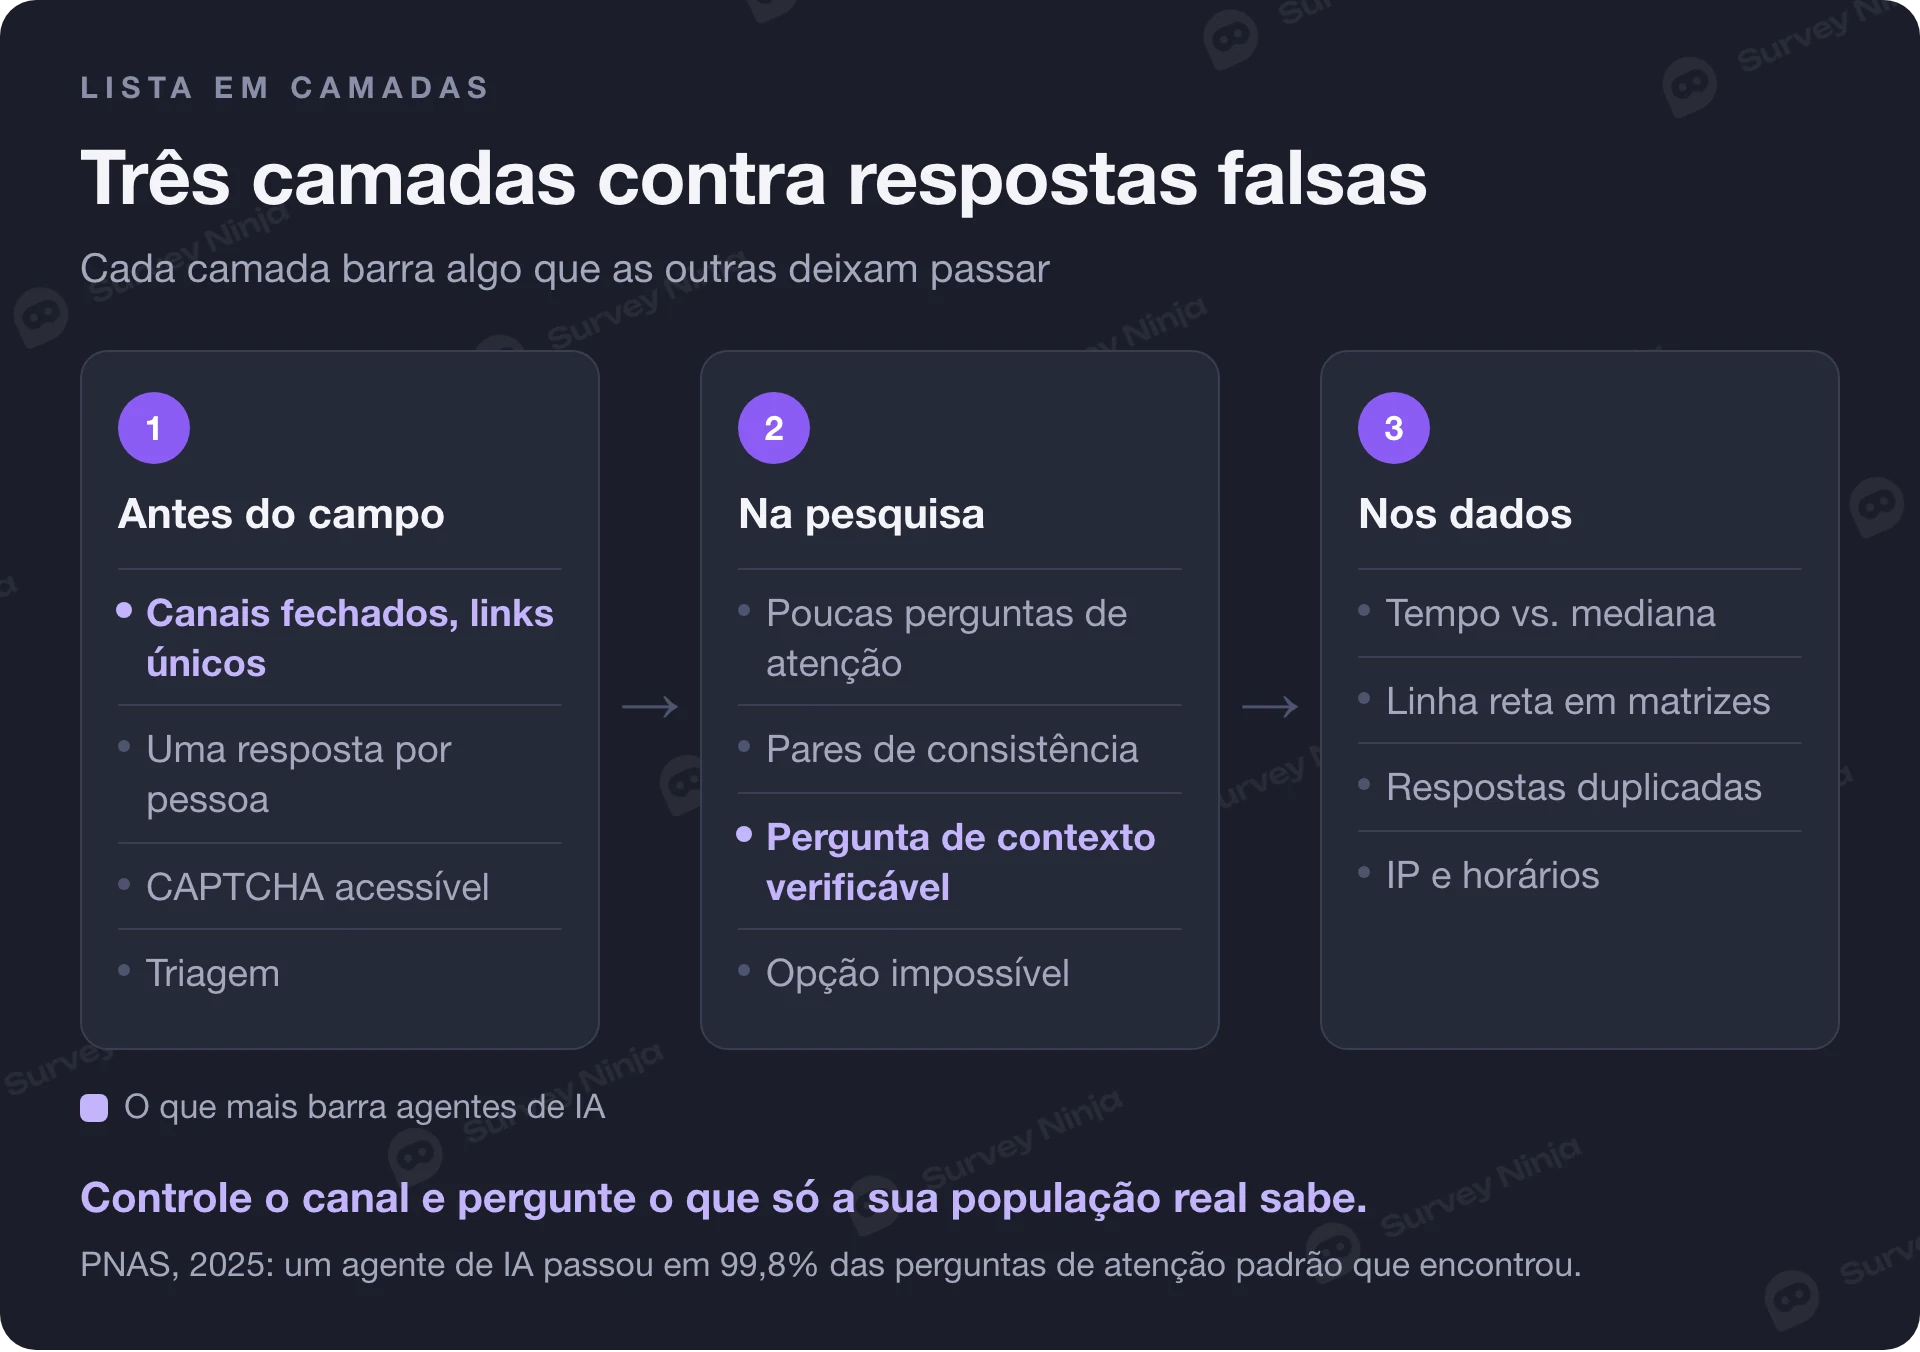
Em 2025, Sean Westwood, de Dartmouth, publicou na PNAS "The potential existential threat of large language models to online survey research". Ele construiu um agente de IA que responde pesquisas com um perfil demográfico coerente e lembra as próprias respostas anteriores. O agente passou em 99,8% das perguntas de atenção padrão aplicadas a ele. Segundo o resumo de Dartmouth, cada resposta falsa custava cerca de cinco centavos de dólar, e em sete grandes pesquisas nacionais antes da eleição de 2024 nos Estados Unidos, de 10 a 52 respostas assim bastariam para inverter o resultado previsto.
A evidência de campo é mais matizada. O acompanhamento do Pew de 2026, No Easy Fix for Bogus Respondents in Online Opt-In Polls, classificou cerca de 1% das respostas abertas como provavelmente escritas por IA e alertou que respostas de IA mais sutis podem ter passado sem detecção. O mesmo relatório mostrou que os controles de velocidade e de respostas em linha reta não pegam a maioria dos respondentes falsos, e que perguntas-armadilha também marcam pessoas legítimas. Um preprint escrito em parte por pesquisadores da empresa de painéis Prolific, noticiado pelo Retraction Watch em abril de 2026, encontrou menos de 1% de cerca de 4.800 respostas de 12 empresas com cara de não humanas e atribuiu a maior parte a bots tradicionais com scripts. A exceção foi a Amazon Mechanical Turk, onde cerca de 16% de 400 respostas foram marcadas como possivelmente escritas por um chatbot. A Prolific financiou o trabalho, e a ferramenta de detecção não está aberta a pesquisadores de fora.
O NORC, da Universidade de Chicago, revisou a literatura num relatório de abril de 2026, Fraudulent respondents and bots in nonprobability surveys. A conclusão é prática: combinar várias defesas, documentar as regras de exclusão antes do campo e preferir desenhos que controlem quem entra na pesquisa. O relatório também alerta que uma triagem agressiva demais tira pessoas reais, sobretudo quem tem pouca familiaridade digital, conexão de internet instável ou padrões de resposta incomuns.
Para quem pesquisa, isso significa duas coisas. Passar numa pergunta de atenção já não prova que uma pessoa respondeu. E controlar o canal, junto com perguntas que só a sua população real consegue responder com detalhe, hoje rende mais do que qualquer pergunta-armadilha.
Lista em camadas contra bots em pesquisas
Cada camada barra algo que as outras deixam passar. Use a tabela para planejar a pesquisa e depois leia como configurar cada checagem.
| Camada | Checagem | O que barra | Onde falha |
|---|---|---|---|
| Antes do campo | Distribuição fechada e links únicos | Desconhecidos, link compartilhado, respostas repetidas de um convite | Não ajuda quando o recrutamento precisa ser público |
| Antes do campo | Uma resposta por pessoa por cookie, IP ou parâmetro do link | Repetições casuais | Cookies são apagados; escritórios e redes móveis compartilham IP |
| Antes do campo | CAPTCHA | Scripts simples | Serviços que resolvem CAPTCHA e agentes de IA capazes |
| Antes do campo | Senha para um grupo conhecido | Qualquer um fora do grupo | Senha publicada não barra nada |
| Antes do campo | Nenhum incentivo visível em posts abertos | Caçadores de prêmios que acham o post | Painéis e amostras convidadas ainda precisam de pagamento |
| Antes do campo | Triagem com desqualificação | Pessoas fora do público-alvo | Fraudadores aprendem qual resposta qualifica |
| Na pesquisa | Uma ou duas perguntas de atenção | Pessoas distraídas, cliques ao acaso | Agentes de IA passam; algumas pessoas reais erram |
| Na pesquisa | Pares de consistência | Respostas descuidadas ou inventadas | Agente de IA com memória se mantém coerente |
| Na pesquisa | Pergunta aberta que exige contexto | Respostas genéricas ou copiadas | Exige revisão manual; a IA escreve com fluência |
| Na pesquisa | Opção impossível (produto ou evento que não existe) | Quem diz sim para tudo | Confunde algumas pessoas honestas |
| Depois | Tempo de resposta comparado à mediana | Quem responde rápido demais | Agente de IA pode ir mais devagar de propósito |
| Depois | Respostas em linha reta em matrizes | Respostas de pouco esforço | Há quem de fato dê a mesma nota para tudo |
| Depois | Respostas abertas duplicadas ou quase idênticas | Fazendas de copiar e colar, uma pessoa respondendo várias vezes | Respostas curtas como "bom" se repetem naturalmente |
| Depois | Combinações impossíveis | Perfis inventados | Exige perguntas pensadas para permitir o cruzamento |
| Depois | Localização do IP e IPs repetidos | Tráfego de fora da região, grupos vindos de uma só fonte | VPN, viagens, redes compartilhadas |
| Depois | Horários de envio | Picos de respostas logo depois que um link vazou | Seus próprios disparos de e-mail também geram picos reais |
Antes do campo: controle quem pode entrar
Distribua por canais fechados. Um e-mail para a sua base de clientes, um link dentro do produto ou uma área de membros mantêm a pesquisa longe de caçadores de prêmios. Links únicos vão além: cada pessoa convidada recebe o seu, e uma segunda resposta pelo mesmo link é fácil de bloquear ou identificar.
Limite a uma resposta por pessoa. O cookie barra repetições casuais no mesmo navegador. O IP barra repetições da mesma conexão, mas pode bloquear colegas que dividem a rede do escritório. Um parâmetro no link, como um ID da sua lista de contatos, liga cada resposta a uma pessoa conhecida e é a opção mais forte das três. O verbete do glossário sobre respostas duplicadas mostra como elas distorcem os resultados.
Ative um CAPTCHA e conheça o limite dele. Ele filtra scripts simples e toma poucos segundos da maioria das pessoas. Alguns CAPTCHAs são difíceis para pessoas com deficiência visual, motora ou cognitiva, então confira se o que você usa pode ser resolvido com leitor de tela e pelo teclado. A revisão do NORC aponta que bots já usam serviços que resolvem CAPTCHA, então trate-o como mais uma camada.
Use senha para grupos conhecidos. Funcionários, alunos de uma turma ou participantes de um evento podem receber a senha junto com o convite.
Deixe incentivos fora dos posts abertos. Se for pagar, diga isso no convite para as pessoas que você escolheu e pague depois que a resposta passar nas suas checagens. Avise a regra desde o início para ser justo, e diga como pedir uma segunda análise se o pagamento de alguém ficar retido.
Faça a triagem primeiro. Coloque as perguntas de qualificação no começo e encerre a pesquisa para quem está fora do alvo com a lógica de desqualificação (screen-out). Não deixe óbvia a resposta que qualifica: pergunte "Quais destas ferramentas você usou no último mês?" com várias opções, em vez de "Você usa software de gestão de projetos?". A calculadora de taxa de incidência mostra quantas pessoas convidar quando você sabe que parcela se qualifica.
Dentro da pesquisa: checagens que ainda funcionam
Perguntas de atenção, com moderação. Uma ou duas instruções como "Nesta linha, marque 'Concordo em parte'" ainda pegam pessoas distraídas e cliques ao acaso. Agentes de IA passam nelas, e o Pew viu que perguntas-armadilha também marcam algumas pessoas honestas. Trate uma falha como um sinal entre vários, e escreva a instrução com palavras claras que um leitor de tela leia em voz alta, nunca só com cor ou posição.
Pares de consistência. Peça o mesmo dado duas vezes de formas diferentes: há quanto tempo a pessoa é cliente no começo e o ano em que começou no fim; o tamanho da equipe numa pergunta e a faixa de tamanho da empresa em outra. Contradições indicam respostas descuidadas ou inventadas. Um agente de IA com memória costuma se manter coerente, então essa checagem pega sobretudo pessoas. Monte os pares com dados de que você já precisa para a análise, não com dados pessoais pedidos só para testar as pessoas.
Uma pergunta aberta que exige contexto. Pergunte algo que alguém da sua população real consegue responder com detalhe e que você consegue conferir. "Qual palestra você assistiu no segundo dia?" para um evento. "Qual foi a sua última compra conosco?" para clientes cujos pedidos você consegue cruzar. Uma resposta fluente e genérica, que serviria para qualquer empresa, é um alerta. Julgue o que a resposta diz, não como ela foi escrita: respostas curtas, erros de digitação, português como segunda língua, tradutor automático ou ditado por voz são normais entre pessoas reais. Detectores de texto de IA também não são atalho: um estudo de Stanford publicado em 2023 na revista Patterns mostrou que sete detectores populares classificaram como geradas por IA mais da metade das redações em inglês escritas por pessoas não nativas. Sozinha, a pergunta aberta já não prova que uma pessoa respondeu; a força dela está em conferir a resposta com dados que você tem.
Uma opção impossível. Inclua uma marca, função ou evento que não existe entre as opções reais. O Pew usou, por exemplo, uma rede social inventada. Um "sim" é um sinal forte, mas o Pew viu que essas opções também confundem algumas pessoas honestas, então redija de um jeito que não dê para confundir com algo real e conte junto com outros alertas.
Depois da coleta: sinais nos dados
Exporte as respostas e passe por estes sinais. Se a sua ferramenta registra o horário de início e de fim, calcule o tempo de cada resposta e compare com a mediana. Defina o limite antes de olhar os dados, por exemplo um terço da mediana medida num piloto.
- Respostas em linha reta: a mesma opção em toda uma matriz de cinco ou mais afirmações, principalmente quando algumas estão invertidas.
- Respostas abertas duplicadas ou quase idênticas: ordene por ordem alfabética ou por tamanho e procure repetições, frases iguais e textos com cara de modelo.
- Combinações impossíveis: alguém de 19 anos com 25 anos de experiência profissional, um cliente que diz usar há três anos um recurso que você lançou no ano passado.
- IP: muitas respostas do mesmo IP em pouco tempo, ou respostas de fora do país-alvo quando a sua população é definida por lugar. Usar VPN não é alerta por si só: muita gente usa no trabalho ou por privacidade.
- Horários: dezenas de respostas em poucos minutos que nenhum disparo seu explica, por exemplo logo depois que o link apareceu num fórum público. O horário sozinho diz pouco: quem trabalha no turno da noite ou mora em outro fuso também responde de madrugada.
- Sim para tudo: concordância com quase todas as perguntas de sim ou não, o padrão que o Pew chama de aquiescência (yea-saying).
Nenhum desses sinais prova fraude sozinho. A regra escrita existe para combiná-los.
IP, dados do dispositivo e IDs que vão no link podem ser dados pessoais pela LGPD e por leis como o GDPR europeu. Informe no convite ou no aviso de privacidade que você coleta esses dados para checagens de qualidade, use-os só para isso e retire-os da base que você analisa e compartilha quando a limpeza terminar. Confira as regras que valem para os seus respondentes. Uma pesquisa que promete anonimato não pode ligar respostas a um ID ou a um IP, então escolha uma das duas coisas antes do campo.
Escreva a regra de limpeza antes do campo
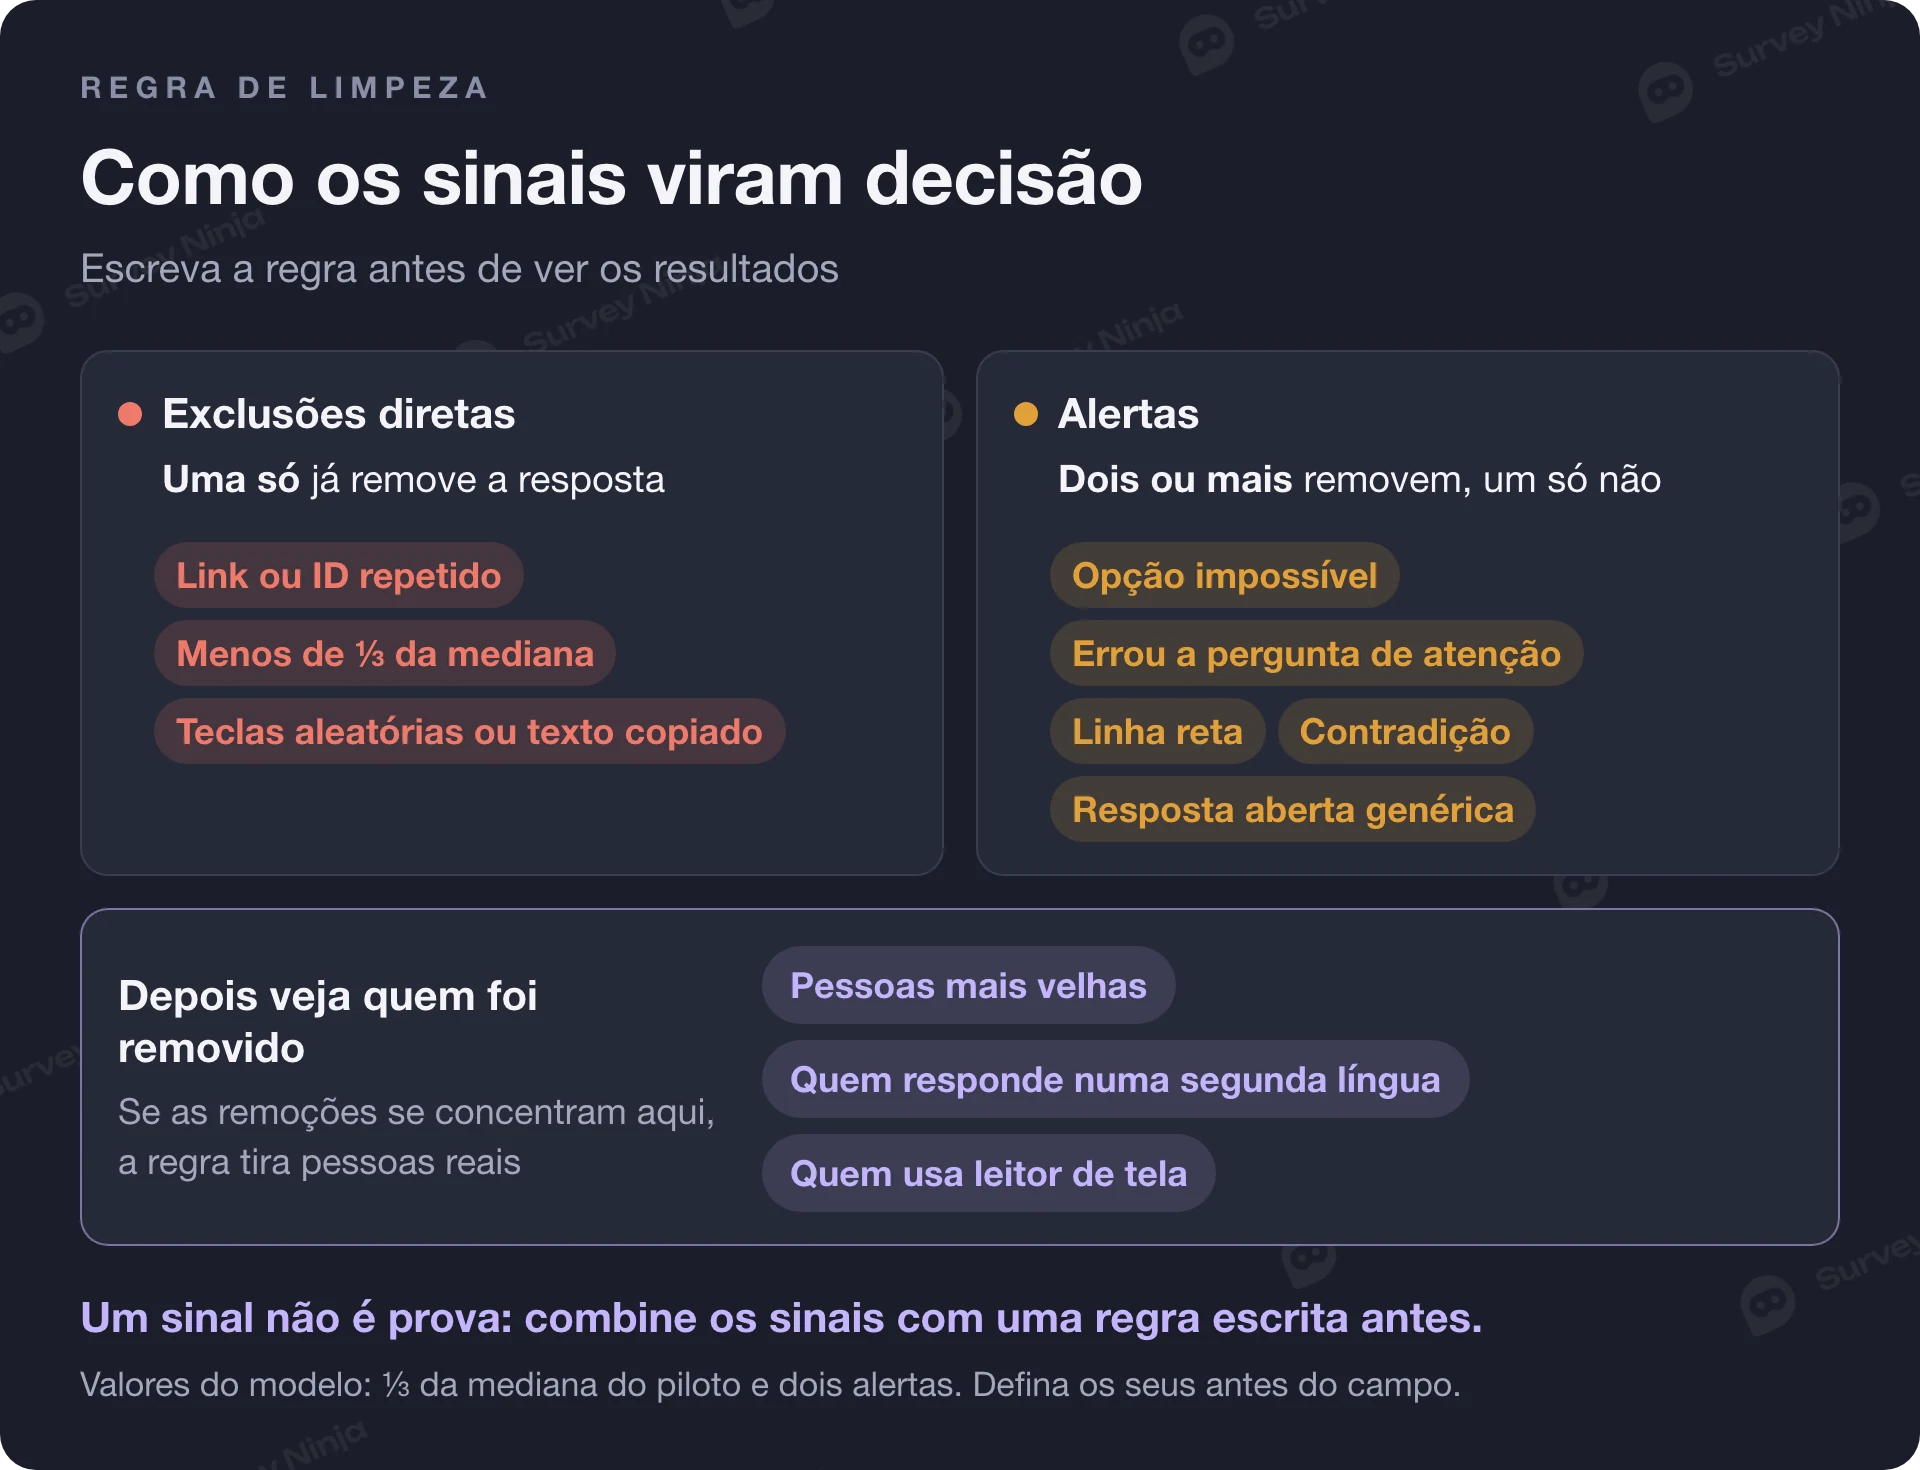
Defina os critérios de exclusão antes de ver os resultados, escreva-os e aplique a todas as respostas. Assim a limpeza não vira escolher as respostas de que você gosta. O relatório do NORC recomenda o mesmo: documentar as regras antes e aplicá-las com transparência. Copie este modelo e preencha os seus valores.
| Parte da regra | Modelo |
|---|---|
| Exclusões diretas: qualquer uma remove a resposta | Segunda resposta pelo mesmo link único ou ID. Tempo abaixo de [um terço] da mediana do piloto. Resposta aberta com teclas aleatórias como "asdfgh", copiada de outra ou sem relação com a pergunta. |
| Alertas: [dois] ou mais removem a resposta | Respondeu "sim" à opção impossível. Errou a pergunta de atenção. Linha reta numa matriz de [5 ou mais] linhas. Contradição num par de consistência. IP fora de [países-alvo], quando a população é definida por lugar. Resposta aberta genérica, sem detalhe do contexto. |
| Casos limítrofes | Revisados por [nome], com o motivo registrado em cada decisão. |
| Relatório | Quantas respostas saíram por categoria, a taxa de remoção total e uma comparação dos resultados principais com e sem as respostas removidas. |
| Mudanças | Qualquer mudança na regra depois do início do campo é datada e explicada no relatório. |
A comparação da linha de relatório importa. Se tirar as respostas marcadas quase não mexe nos resultados, a limpeza protegeu você do ruído. Se mexe muito, olhe quem foi removido antes de confiar em qualquer uma das versões: se as remoções se concentram em pessoas mais velhas, em quem responde pelo celular ou em quem escreve numa segunda língua, a regra está tirando pessoas reais. No relatório do Pew de 2026, cruzar uma amostra opt-in com cadastros de eleitores removeu principalmente pessoas válidas e aumentou um pouco o erro das estimativas.
Para medir o efeito, informe seus totais na calculadora de limpeza de dados de pesquisa, que é gratuita: total de respostas e depois as rápidas demais, os padrões repetidos, as duplicadas e outras de baixa qualidade. Ela devolve quantas respostas válidas sobram e a taxa de remoção, o que mostra se é preciso completar a amostra e quanta folga planejar na próxima onda.
Como proteger uma pesquisa no SurveyNinja
O SurveyNinja cobre a camada "antes do campo" em todos os planos, inclusive o gratuito: senha, CAPTCHA, uma resposta por pessoa por cookie, IP ou parâmetro do link, listas de IP e restrições por dispositivo. Links únicos para cada pessoa convidada estão disponíveis a partir do plano Padrão. A lógica, inclusive a desqualificação, funciona em todos os planos, então uma pergunta de triagem pode encerrar a pesquisa para quem está fora do alvo, e as cotas fecham um grupo quando ele enche. Variáveis ocultas no link, a partir do plano Básico, podem levar um ID de cliente ou de membro para você cruzar depois as respostas abertas com os seus registros. Diga isso no convite: uma pesquisa ligada a um ID não é anônima.
Exporte as respostas para CSV, XLSX ou SPSS em qualquer plano e aplique a regra de limpeza numa planilha ou no seu pacote estatístico. Se for checar IP, decida antes do campo se vai usar o modo anônimo, como explica o nosso guia sobre pesquisas realmente anônimas. No fim, registre as contagens na calculadora de limpeza para o relatório.
Perguntas frequentes
Como saber se as respostas de uma pesquisa são de bots?
Procure vários sinais juntos: tempos muito abaixo da mediana, respostas em linha reta em matrizes, respostas abertas duplicadas ou com cara de modelo, combinações impossíveis, muitas respostas do mesmo IP e picos repentinos de respostas que nenhum disparo seu explica. Um sinal sozinho raramente prova algo, então use uma regra escrita que combine todos.
A IA consegue passar nas perguntas de atenção?
Sim. Num estudo publicado na PNAS em 2025, o agente de IA de Sean Westwood passou em 99,8% das perguntas de atenção padrão e manteve um perfil coerente. Essas perguntas ainda pegam pessoas distraídas e scripts simples, mas passar nelas já não prova que uma pessoa respondeu.
CAPTCHA impede bots em pesquisas?
Ele barra scripts simples e toma poucos segundos da maioria, então vale ativar, desde que quem usa leitor de tela ou teclado também consiga resolver. Não barra quem usa serviços que resolvem CAPTCHA nem agentes de IA capazes. Combine com distribuição fechada, uma resposta por pessoa e checagens nos dados depois da coleta.
O que é um "speeder" numa pesquisa?
É quem termina muito mais rápido do que a leitura das perguntas permite. Defina o limite antes do campo, por exemplo um terço da mediana de um piloto, e trate a velocidade como um sinal entre outros: existem leitores rápidos e cuidadosos, e um agente de IA pode ir mais devagar.
Como evitar respostas duplicadas numa pesquisa?
Envie links únicos ou passe no link um ID da sua lista de contatos, e permita uma resposta por pessoa por cookie, IP ou parâmetro do link. Depois da coleta, confira IDs repetidos, IPs repetidos e respostas abertas quase idênticas.
Qual a porcentagem de respostas fraudulentas em pesquisas online?
Depende do canal. O Pew Research Center encontrou em 2020 de 4% a 7% de respondentes falsos em fontes online opt-in, contra cerca de 1% em painéis recrutados por correspondência. Links públicos com incentivo visível podem atrair muito mais, então meça a sua própria taxa de remoção.
Publicado: 16 nov 2026