


 25 preguntas para una encuesta a clientes de una constructora

Cómo cruzar resultados de encuestas y elegir el porcentaje correcto
Útil  Mike Taylor 11 oct. 2026 Tiempo de lectura ≈ 20 min
La tabulación cruzada compara respuestas entre grupos, pero el denominador determina qué significa cada porcentaje. Con una encuesta ficticia a clientes, pasaremos de los registros individuales a las frecuencias, los porcentajes por fila y columna, los datos ausentes y una conclusión verificable.
Qué puedes saber con una tabla cruzada
Una tabulación cruzada, también llamada tabla de contingencia, cuenta las combinaciones de dos variables categóricas. Si colocas el tipo de cliente en las filas y la satisfacción en las columnas, cada celda indica cuántas personas cumplen ambas condiciones. Los totales de los bordes son los totales marginales.
Empieza por una pregunta concreta: ¿los clientes recurrentes están menos satisfechos que quienes compraron por primera vez? Una tabla cruzada permite ver esa comparación cuando las categorías y la población analizada están bien definidas. El porcentaje global de satisfacción mezclaría ambos grupos y ocultaría sus diferentes patrones de respuesta.
Esta guía se centra en elegir denominadores y reproducir los cálculos. El análisis descriptivo cubre frecuencias, promedios y dispersión; aquí reconstruiremos varias lecturas de una tabla y justificaremos las exclusiones. Todos los registros del ejemplo son ficticios, sin ponderación y creados para este ejercicio.
Prepara una fila por respuesta
Una tienda imaginaria hace dos preguntas de respuesta única: «¿Tu compra más reciente fue tu primera compra en nuestra tienda?» y «En general, ¿quedaste satisfecho con tu compra más reciente?». Los códigos son first para la primera compra y returning para una compra posterior, seguidos de yes o no. Para facilitar los cálculos, usamos satisfacción binaria y no una escala CSAT de varios puntos.
Quienes responden «no» ven una pregunta opcional: «¿Qué aspectos te decepcionaron? Selecciona todos los que correspondan: precio, entrega, atención». El archivo guarda cada opción en una columna independiente. Entre quienes contestaron esa pregunta, 1 significa seleccionada y 0 significa no seleccionada; los campos vacíos corresponden a una pregunta omitida o que no se mostró.
El CSV completo que aparece al final contiene 108 identificadores únicos. Cada fila representa una respuesta a la encuesta y, en este ejemplo, suponemos que procede de una persona distinta. En una investigación real, comprueba los envíos repetidos y documenta cómo los tratarás. La columna auxiliar pair_valid vale 1 únicamente cuando están presentes el tipo de cliente y la satisfacción.
Conserva la exportación original y prepara los cálculos en otra hoja. Una preparación coherente de los datos evita que «Returning», «returning» y un espacio al final se conviertan en grupos distintos dentro de la tabla dinámica. Si el cuestionario incluía «no estoy seguro», conserva esa categoría y explica su tratamiento antes de calcular porcentajes.
Comprueba primero las frecuencias
La tabla inicial utiliza los 100 registros con pair_valid=1. Hay 40 clientes de primera compra y 60 recurrentes; 50 declaran satisfacción y otros 50 responden que no. Estas son las frecuencias de ambos grupos:
| Cliente | Sí | No | Base |
|---|---|---|---|
| Primera compra | 28 | 12 | 40 |
| Recurrente | 22 | 38 | 60 |
| Total | 50 | 50 | 100 |
La celda superior izquierda contiene 28 clientes de primera compra que respondieron «sí». Será el numerador de tres cálculos diferentes, pero su denominador dependerá de lo que queramos saber. Un encabezado como «Satisfacción por tipo de cliente, %» resulta incompleto porque no identifica la base del porcentaje.
Revisa las sumas en ambas direcciones: 28 + 12 = 40 y 22 + 38 = 60; 28 + 22 = 50 y 12 + 38 = 50. Las cuatro celdas interiores suman 100. Si tu tabla muestra 108, está incorporando los valores ausentes mediante otra regla y tendrás que explicar esa diferencia.
Los porcentajes por fila comparan resultados dentro de cada grupo
Para comparar la satisfacción entre tipos de cliente, divide cada celda por el total de su fila. En primera compra, 28/40 = 70,0% están satisfechos y 12/40 = 30,0% no lo están. Entre los recurrentes, 22/60 = 36,7% están satisfechos y 38/60 = 63,3% no, con redondeo a un decimal.
Cada fila suma el 100%, salvo posibles diferencias de redondeo. Esta lectura sirve para comparar la satisfacción de los clientes: cada grupo tiene su propia base, por lo que su tamaño no determina automáticamente la tasa observada. Compara el 70,0% con el 36,7% y muestra también las fracciones 28/40 y 22/60.
La diferencia es de 33,3 puntos porcentuales, calculada con las tasas sin redondear y redondeada al final. Decir «un 33,3% más de satisfacción» sugeriría un cambio relativo y comunicaría otra medida. Cuando una fila no contiene personas, su porcentaje no está definido; indica que no está disponible en lugar de mostrar un 0% observado.
Los porcentajes por columna y sobre el total responden otras preguntas
Los porcentajes por columna describen la composición de un resultado. De las 50 personas satisfechas, 28/50 = 56,0% son de primera compra y 22/50 = 44,0% son recurrentes. Entre las 50 insatisfechas, el reparto es 24,0% de primera compra y 76,0% recurrentes, de modo que cada columna de resultado suma el 100%.
Esta lectura ayuda a organizar el seguimiento de las personas insatisfechas. Indica de qué grupos proceden, mientras que los porcentajes por fila indican la frecuencia de insatisfacción dentro de cada grupo. El 76,0% por sí solo no significa que el 76,0% de los clientes recurrentes esté insatisfecho.
Los porcentajes sobre el total utilizan como denominador las 100 respuestas válidas para ambas preguntas. Las cuatro celdas interiores pasan a ser 28,0%, 12,0%, 22,0% y 38,0%, que juntas suman el 100%. Este formato describe cómo se distribuye la muestra analizada entre las combinaciones y qué parte ocupa una celda concreta.
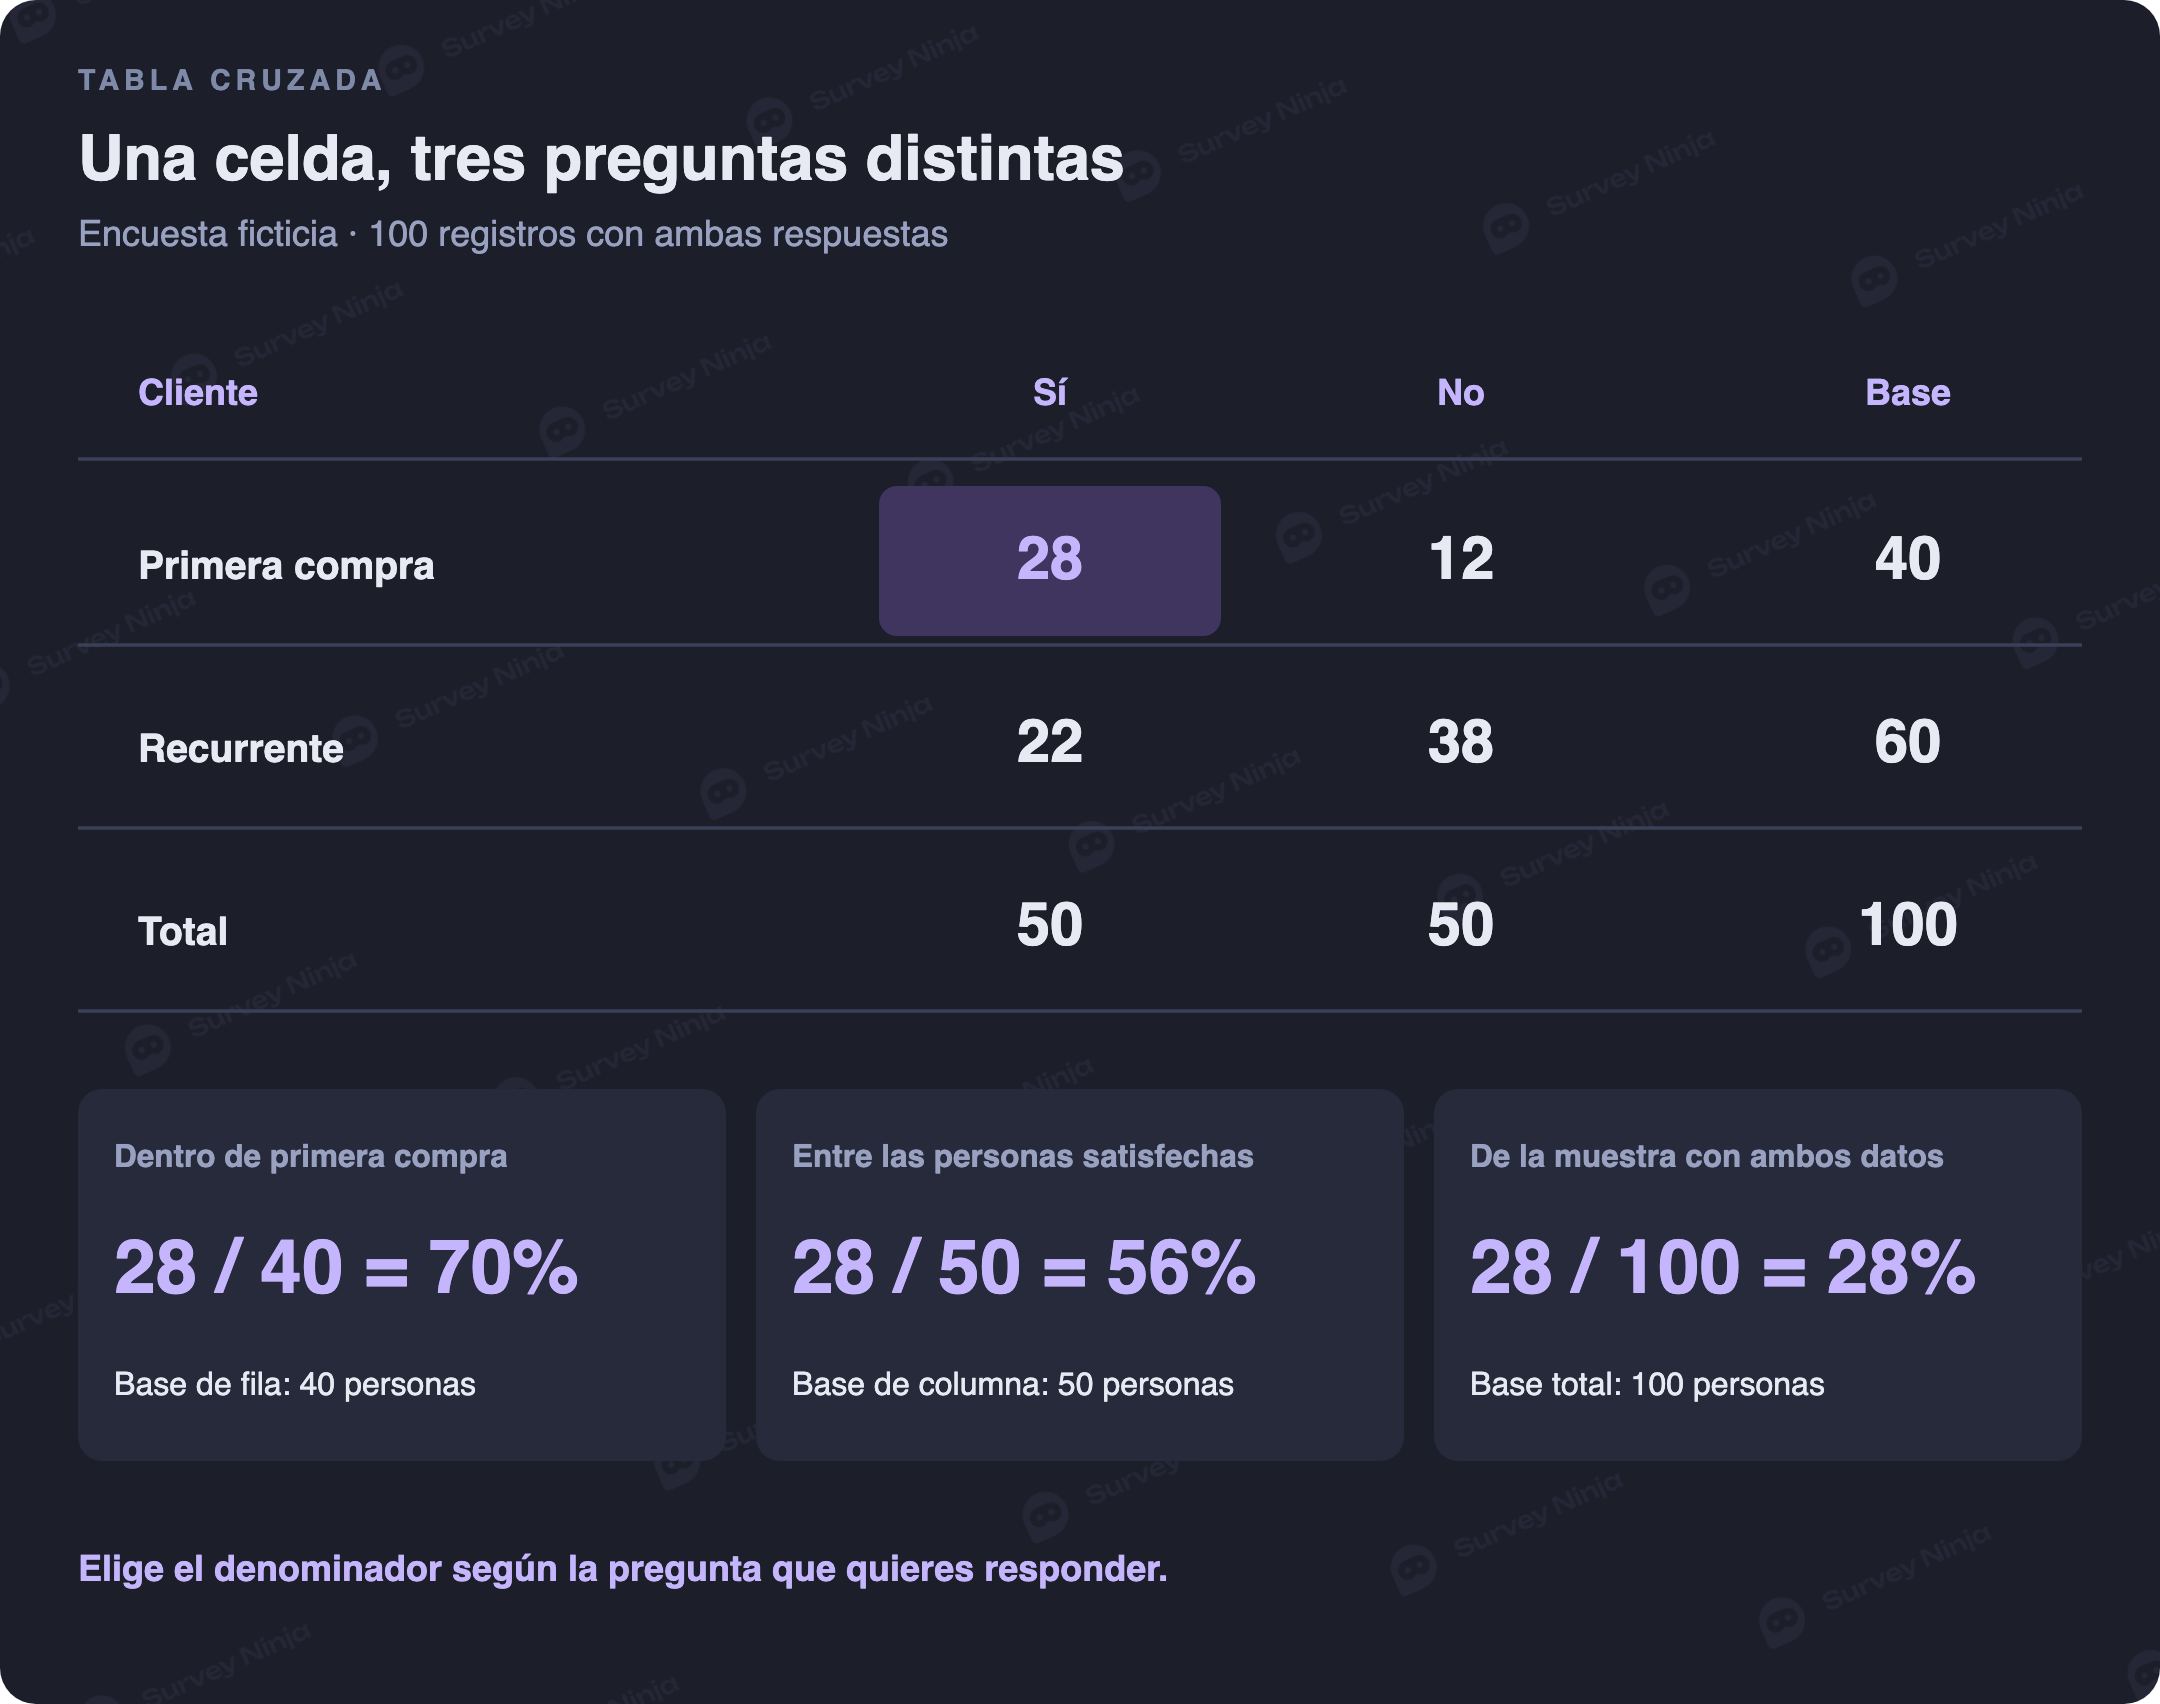
Los tres porcentajes son correctos, pero confunden si responden una pregunta distinta o cambian de denominador entre gráficos sin advertirlo. Elige la lectura antes de diseñar el gráfico y coloca la base junto al porcentaje.
Trata los datos ausentes sin contar dos veces a una persona
Ocho de los 108 registros no entran en la tabla principal: cuatro carecen solo del tipo de cliente, tres carecen solo de satisfacción y uno carece de ambos datos. Estas categorías no se solapan, por lo que 108 − 4 − 3 − 1 = 100. Puedes localizarlas filtrando pair_valid=0 en el CSV.
Si cuentas los campos vacíos por separado, encontrarás cinco valores ausentes en tipo de cliente y cuatro en satisfacción. Restar ambos números de 108 daría 99, porque excluirías dos veces a la persona que no respondió ninguna de las dos preguntas. La regla debe contar personas excluidas y no simplemente celdas vacías.
En todo el archivo hay 104 respuestas válidas de satisfacción, incluidas dos respuestas «sí» y dos «no» sin tipo de cliente conocido. La satisfacción global para esa pregunta es 52/104 = 50,0%. La tabla de respuestas completas también da 50,0%, pero su base es 100; que coincidan los porcentajes no vuelve intercambiables las poblaciones.
Explica las exclusiones y revisa si la falta de respuesta cambia según el grupo. El grupo conocido de primera compra tiene 42 registros y a dos les falta satisfacción; el recurrente tiene 61 y a uno le falta. El análisis de casos completos describe a quienes contestaron ambas preguntas, sin recuperar la opinión de quienes dejaron alguna en blanco.
La selección múltiple necesita una base de personas
Usaremos ahora el mismo archivo para la pregunta de seguimiento, manteniendo como población los 100 registros válidos para ambas preguntas principales. Solo las 50 personas insatisfechas podían responderla: cuatro la omitieron y 46 seleccionaron algún aspecto. Las dos personas insatisfechas sin tipo de cliente continúan fuera de este análisis.
Entre esas 46 personas, 24 seleccionaron precio, 27 entrega y 12 atención. Dividir cada frecuencia entre 46 da 52,2%, 58,7% y 26,1%. Tras redondear, suman el 137,0%, porque una persona podía elegir varios aspectos; en conjunto se registraron 63 selecciones.
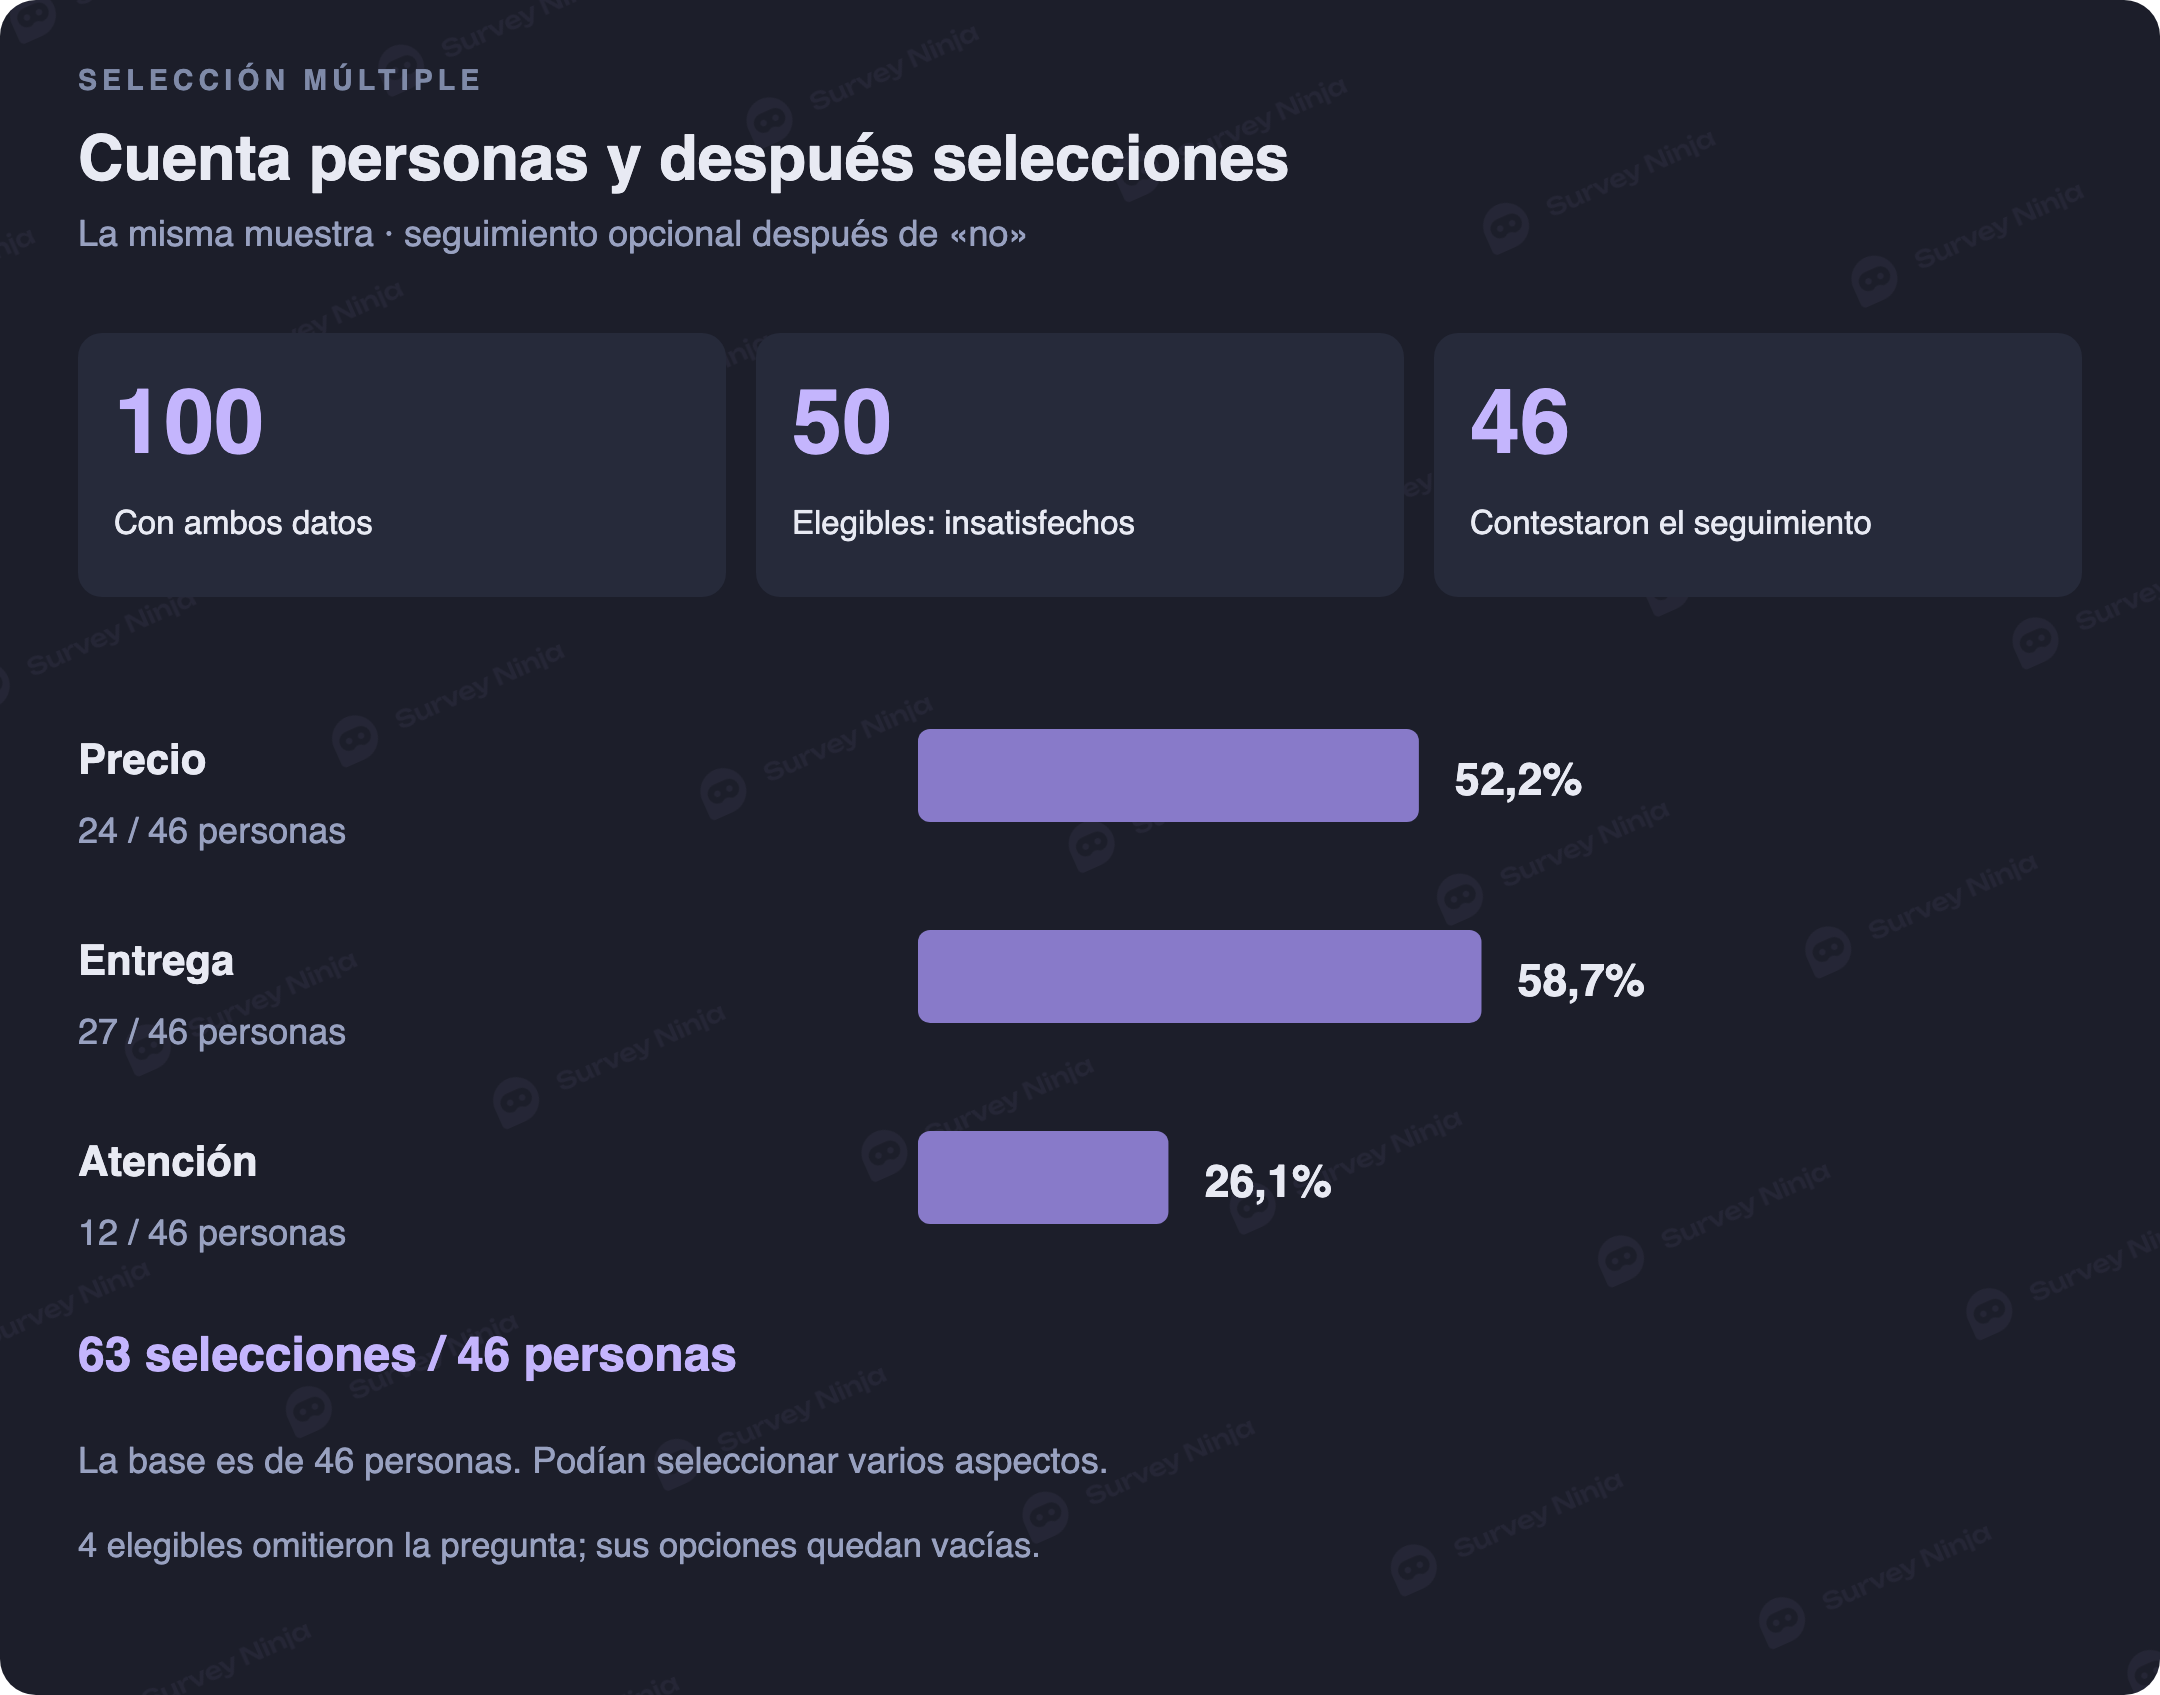
Dividir entre 63 describiría el reparto de selecciones: precio representaría el 38,1% de todas las selecciones. Es una medida válida si la etiquetas así, pero no indica qué porcentaje de personas eligió precio. Usar las 50 personas elegibles daría un 48,0% y mantendría en el denominador las cuatro respuestas omitidas.
Para cruzar motivos con tipo de cliente, las bases válidas del seguimiento son 10 personas de primera compra y 36 recurrentes. Precio aparece en 6/10 = 60,0% frente a 18/36 = 50,0%. Muestra siempre esas bases: usar 40 y 60 incluiría personas satisfechas, respuestas omitidas y personas que nunca vieron la pregunta, cambiando la medida.
Exporta las respuestas de SurveyNinja y prepara la tabla
En SurveyNinja, abre el área Results del cuestionario y elige Responses. Comprueba si estás viendo Completed o Incomplete, y abre Filter para revisar el periodo y las restricciones por respuesta. Anota esos ajustes antes de exportar, ya que cualquier cambio en la población seleccionada modifica los denominadores posteriores.
En Download, selecciona CSV o XLSX, continúa a la configuración de exportación y descarga el archivo. Para una tabla de frecuencias sencilla, deja desactivadas las columnas opcionales de tiempo por pregunta y posición de visualización, salvo que las necesites. La guía de descarga de respuestas explica el punto de partida; conserva una copia sin cambios y comprueba qué registros contiene.
En este recorrido, la tabla cruzada se construye en una hoja de cálculo después de exportar. El CSV del ejercicio tiene una estructura didáctica, así que adapta los nombres de las columnas de tu exportación y no esperes encontrar exactamente estos campos. Consulta exportación de datos para decidir qué compartir y elimina identificadores personales innecesarios para el análisis.
En Excel, selecciona los registros preparados e inserta una tabla dinámica. Coloca customer_type en Filas, satisfied en Columnas e id en Valores, con el cálculo Recuento. Añade pair_valid como filtro y selecciona 1. Comprueba estas frecuencias antes de calcular porcentajes.
Añade de nuevo el campo de recuento si quieres mostrar frecuencias y porcentajes juntos. En Mostrar valores como, elige porcentaje del total de fila, del total de columna o del total general; Microsoft explica estas opciones. Google Sheets ofrece un flujo de tablas dinámicas con filas, columnas, valores y filtros. Configura el recuento y comprueba la base.
Verifica una celda con una fórmula
Si los encabezados del CSV están en la fila 1, el tipo de cliente en B, la satisfacción en C y la validez conjunta en H, esta fórmula cuenta la celda superior izquierda. Los rangos incluyen los 108 registros:
=COUNTIFS(B2:B109,"first",C2:C109,"yes",H2:H109,1)La fórmula devuelve 28 y usa funciones en inglés; Excel en español utiliza CONTAR.SI.CONJUNTO y el separador depende de la configuración regional. En otra hoja, coloca las cuatro frecuencias en B2:C3, los totales de fila en D2:D3, los de columna en B4:C4 y el total general en D4. Calcula =B2/$D2, =B2/B$4 y =B2/$D$4 para fila, columna y total, respectivamente.
Redacta una conclusión que puedas sostener
Una conclusión ajustada a los datos sería: «Entre las 100 personas ficticias que respondieron ambas preguntas, 28 de los 40 clientes de primera compra declararon satisfacción, frente a 22 de los 60 recurrentes. La diferencia observada fue de 33,3 puntos porcentuales. Se excluyeron ocho registros porque faltaba el tipo de cliente, la satisfacción o ambos».
Se trata de una comparación descriptiva. El tipo de cliente no se asignó al azar, por lo que la tabla no demuestra que volver a comprar cause menor satisfacción. La captación de participantes, los productos comprados, el tiempo transcurrido y las respuestas ausentes pueden afectar el patrón.
La comparación de motivos tiene una base especialmente pequeña de primera compra: 10 personas, por lo que una sola cambia el porcentaje en 10 puntos. No existe un tamaño universal de celda que garantice fiabilidad. Muestra frecuencias, evita interpretar pequeñas diferencias como posiciones estables y prepara un plan de tamaño de muestra adecuado a la precisión y los grupos necesarios.
Una prueba chi-cuadrado añade una pregunta inferencial y exige revisar independencia, frecuencias esperadas y diseño muestral. Varias selecciones de una persona no equivalen a participantes independientes en una tabla de contingencia ordinaria. Si hay ponderaciones, muestras complejas o mediciones repetidas, aplica un método apropiado; muestra siempre el número real de participantes aunque presentes porcentajes ponderados.
Define la comparación antes de recoger respuestas. Incluye la pregunta de grupo, decide quién verá el seguimiento y registra la base del informe. Puedes crear una encuesta en SurveyNinja, probar sus rutas y exportar las respuestas. Añadir una variable de grupo después no recupera una respuesta que nunca se pidió.
Copia el CSV completo del ejemplo
Guarda este archivo ficticio como CSV UTF-8, impórtalo con comas como delimitador y conserva los campos vacíos. Los códigos permanecen en inglés para reproducir las fórmulas: answered significa que se contestó el seguimiento, skipped que se omitió y not_asked que no se mostró. La columna pair_valid identifica las dos respuestas principales presentes.
id,customer_type,satisfied,reason_state,price,delivery,support,pair_valid
C001,first,yes,not_asked,,,,1
C002,first,yes,not_asked,,,,1
C003,first,yes,not_asked,,,,1
C004,first,yes,not_asked,,,,1
C005,first,yes,not_asked,,,,1
C006,first,yes,not_asked,,,,1
C007,first,yes,not_asked,,,,1
C008,first,yes,not_asked,,,,1
C009,first,yes,not_asked,,,,1
C010,first,yes,not_asked,,,,1
C011,first,yes,not_asked,,,,1
C012,first,yes,not_asked,,,,1
C013,first,yes,not_asked,,,,1
C014,first,yes,not_asked,,,,1
C015,first,yes,not_asked,,,,1
C016,first,yes,not_asked,,,,1
C017,first,yes,not_asked,,,,1
C018,first,yes,not_asked,,,,1
C019,first,yes,not_asked,,,,1
C020,first,yes,not_asked,,,,1
C021,first,yes,not_asked,,,,1
C022,first,yes,not_asked,,,,1
C023,first,yes,not_asked,,,,1
C024,first,yes,not_asked,,,,1
C025,first,yes,not_asked,,,,1
C026,first,yes,not_asked,,,,1
C027,first,yes,not_asked,,,,1
C028,first,yes,not_asked,,,,1
C029,first,no,answered,1,0,1,1
C030,first,no,answered,1,0,1,1
C031,first,no,answered,1,0,1,1
C032,first,no,answered,1,0,0,1
C033,first,no,answered,1,0,0,1
C034,first,no,answered,1,1,0,1
C035,first,no,answered,0,1,0,1
C036,first,no,answered,0,1,0,1
C037,first,no,answered,0,1,0,1
C038,first,no,answered,0,1,0,1
C039,first,no,skipped,,,,1
C040,first,no,skipped,,,,1
C041,returning,yes,not_asked,,,,1
C042,returning,yes,not_asked,,,,1
C043,returning,yes,not_asked,,,,1
C044,returning,yes,not_asked,,,,1
C045,returning,yes,not_asked,,,,1
C046,returning,yes,not_asked,,,,1
C047,returning,yes,not_asked,,,,1
C048,returning,yes,not_asked,,,,1
C049,returning,yes,not_asked,,,,1
C050,returning,yes,not_asked,,,,1
C051,returning,yes,not_asked,,,,1
C052,returning,yes,not_asked,,,,1
C053,returning,yes,not_asked,,,,1
C054,returning,yes,not_asked,,,,1
C055,returning,yes,not_asked,,,,1
C056,returning,yes,not_asked,,,,1
C057,returning,yes,not_asked,,,,1
C058,returning,yes,not_asked,,,,1
C059,returning,yes,not_asked,,,,1
C060,returning,yes,not_asked,,,,1
C061,returning,yes,not_asked,,,,1
C062,returning,yes,not_asked,,,,1
C063,returning,no,answered,1,0,1,1
C064,returning,no,answered,1,0,1,1
C065,returning,no,answered,1,0,1,1
C066,returning,no,answered,1,0,1,1
C067,returning,no,answered,1,0,1,1
C068,returning,no,answered,1,0,1,1
C069,returning,no,answered,1,0,1,1
C070,returning,no,answered,1,0,1,1
C071,returning,no,answered,1,0,1,1
C072,returning,no,answered,1,0,0,1
C073,returning,no,answered,1,0,0,1
C074,returning,no,answered,1,0,0,1
C075,returning,no,answered,1,0,0,1
C076,returning,no,answered,1,0,0,1
C077,returning,no,answered,1,1,0,1
C078,returning,no,answered,1,1,0,1
C079,returning,no,answered,1,1,0,1
C080,returning,no,answered,1,1,0,1
C081,returning,no,answered,0,1,0,1
C082,returning,no,answered,0,1,0,1
C083,returning,no,answered,0,1,0,1
C084,returning,no,answered,0,1,0,1
C085,returning,no,answered,0,1,0,1
C086,returning,no,answered,0,1,0,1
C087,returning,no,answered,0,1,0,1
C088,returning,no,answered,0,1,0,1
C089,returning,no,answered,0,1,0,1
C090,returning,no,answered,0,1,0,1
C091,returning,no,answered,0,1,0,1
C092,returning,no,answered,0,1,0,1
C093,returning,no,answered,0,1,0,1
C094,returning,no,answered,0,1,0,1
C095,returning,no,answered,0,1,0,1
C096,returning,no,answered,0,1,0,1
C097,returning,no,answered,0,1,0,1
C098,returning,no,answered,0,1,0,1
C099,returning,no,skipped,,,,1
C100,returning,no,skipped,,,,1
C101,,yes,not_asked,,,,0
C102,,yes,not_asked,,,,0
C103,,no,answered,1,0,0,0
C104,,no,answered,0,1,0,0
C105,first,,not_asked,,,,0
C106,first,,not_asked,,,,0
C107,returning,,not_asked,,,,0
C108,,,not_asked,,,,0
Preguntas frecuentes
¿Qué es la tabulación cruzada en una encuesta?
Es una tabla de frecuencias para combinaciones de dos variables categóricas, como tipo de cliente y satisfacción. Los porcentajes pueden describir resultados dentro de un grupo, la composición de un resultado o el reparto de toda la muestra analizada, según el denominador.
¿Debo usar porcentajes por fila o por columna?
Usa porcentajes por fila para comparar resultados dentro de los grupos cuando los grupos ocupan las filas. Usa porcentajes por columna para describir quién compone un resultado cuando los resultados ocupan las columnas. Si cambias la orientación, cambia también la dirección del cálculo; elige la base según la pregunta.
¿Por qué una misma celda puede ser el 70%, el 56% y el 28%?
La celda contiene 28 personas. Dividir entre el total de su fila, 40, da el 70%; entre el total de su columna, 50, da el 56%; y entre las 100 respuestas válidas para ambas preguntas, el 28%. Cada cálculo describe una población diferente.
¿Cómo trato las respuestas ausentes?
Define qué registros pueden entrar en cada tabla y cuenta las personas excluidas sin duplicarlas. El ejemplo principal usa 100 de 108 registros con ambas respuestas presentes. A cuatro les falta solo el tipo de cliente, a tres solo satisfacción y a uno ambos datos.
¿Por qué la selección múltiple puede sumar más del 100%?
Una persona puede marcar varias opciones. En el seguimiento, 46 personas hacen 63 selecciones, por lo que los porcentajes calculados sobre personas suman el 137,0% tras redondear. Los porcentajes sobre selecciones responden otra pregunta y deben identificarse por separado.
¿Puedo construir la tabla en Excel o Google Sheets?
Sí. Coloca el grupo en Filas, el resultado en Columnas y el identificador único de respuesta en Valores, con el cálculo Recuento. Aplica el filtro de elegibilidad, comprueba las frecuencias y después elige el denominador del porcentaje. Mantén visibles las frecuencias originales.
¿Una tabla cruzada demuestra diferencias entre grupos?
Muestra un patrón observado en las respuestas analizadas. Una afirmación sobre la población necesita un método muestral e inferencial apropiado, y una asociación por sí sola no demuestra causalidad. Los grupos pequeños, los datos ausentes y las respuestas repetidas pueden afectar la interpretación.
¿Puedo utilizar respuestas ponderadas?
Los porcentajes ponderados necesitan sumar los pesos de los mismos registros elegibles tanto en el numerador como en el denominador. Presenta por separado el número real de participantes y documenta el método. El CSV del ejercicio no está ponderado, por lo que cuenta personas.
Publicado: 11 oct. 2026