Límites de Google Forms: respuestas, archivos, temporizador y lógica, con soluciones
Muestreo no probabilístico: qué es, tipos y ejemplos en encuestas
Métodos de investigación  Mike Taylor 18 nov. 2026 Tiempo de lectura ≈ 20 min
Contenidos
- ¿Qué es el muestreo no probabilístico?
- Muestreo probabilístico y no probabilístico: diferencias
- Tipos de muestreo no probabilístico
- ¿Qué tipo de muestreo no probabilístico elegir?
- Ejemplo práctico: muestreo por conveniencia contra muestreo por cuotas
- Qué puedes afirmar y qué no con una muestra no probabilística
- Cómo redactar el muestreo no probabilístico en la metodología de tu tesis
- Cómo reducir el sesgo en una muestra no probabilística
- Cómo levantar una encuesta no probabilística en SurveyNinja
- Preguntas frecuentes
El muestreo no probabilístico es una forma de elegir a los participantes de una encuesta en la que el investigador o los propios encuestados deciden quién entra, así que nadie tiene una probabilidad conocida de ser seleccionado. Los tipos más usados son el muestreo por conveniencia, el intencional, el de cuotas, el de bola de nieve y el voluntario. Aquí tienes cada tipo con un ejemplo, la diferencia con el muestreo probabilístico, qué puedes afirmar y un párrafo modelo para tu tesis.
Esta guía complementa nuestro artículo sobre muestreo probabilístico (aleatorio simple, sistemático, estratificado y por conglomerados). Aquí hablamos de las muestras que en la práctica levantan casi todos los tesistas, equipos de producto y organizaciones civiles.
Puntos clave
- En el muestreo no probabilístico la gente entra a la muestra porque es fácil de contactar, porque el investigador la elige, porque alguien la recomienda o porque se ofrece, así que su probabilidad de selección es desconocida.
- Conveniencia, intencional, cuotas, bola de nieve y voluntario sirven para objetivos distintos, y cada uno trae su propio sesgo de selección.
- El margen de error no tiene sentido en estas muestras: describe a quienes respondieron y no hagas afirmaciones sobre toda la población.
- Cuotas en dos o tres variables clave y una metodología transparente hacen mucho más defendible una encuesta no probabilística.
¿Qué es el muestreo no probabilístico?
El muestreo no probabilístico es cualquier método en el que la inclusión depende del criterio del investigador, del acceso o de la autoselección, y no de un sorteo sobre una lista de toda la población. Como la probabilidad de selección es desconocida, el error muestral no se puede calcular de la forma habitual. Algunos manuales de metodología muy usados en México y Latinoamérica llaman a estas muestras «dirigidas».
En una muestra probabilística partes de una lista completa de la población, como todos los alumnos inscritos, y un proceso aleatorio decide a quién invitar. En una muestra no probabilística muchas veces no existe esa lista. Compartes el enlace en un grupo de Facebook, pides a tus compañeros que lo reenvíen o eliges a diez expertos de confianza. Las respuestas son datos válidos sobre quienes las dieron. Lo que queda abierto es cuánto se parecen esas personas al resto.
Esa pregunta tiene historia. En 1948 las tres encuestadoras más importantes de Estados Unidos, Crossley, Gallup y Roper, usaron muestreo por cuotas y las tres pronosticaron que Thomas Dewey le ganaría a Harry Truman. El informe de 2013 del grupo de trabajo de AAPOR sobre muestreo no probabilístico recuerda que los entrevistadores, al llenar sus cuotas, tendían a elegir a personas con más estudios y mejor posición económica, lo que sesgó las muestras en contra de Truman. Gallup pasó poco después a métodos probabilísticos, pero las cuotas y los demás métodos no probabilísticos siguen siendo comunes en investigación de mercados, estudios cualitativos y en la mayoría de las tesis.
Muestreo probabilístico y no probabilístico: diferencias
La diferencia está en quién decide quién entra. En el muestreo probabilístico decide un proceso aleatorio, y por eso puedes medir cuánto pueden alejarse los resultados de la población. En el no probabilístico decide una persona, y cambias esa precisión medible por rapidez, menor costo y acceso a grupos sin lista.
| Aspecto | Aleatorio | No aleatorio |
|---|---|---|
| Quién decide la selección | Un proceso aleatorio | Quien investiga, una cadena de referidos o el propio encuestado |
| Probabilidad de selección | Conocida y mayor que cero para todos en la lista | No se conoce, y es cero para quien el método no alcanza |
| Requiere un marco muestral (lista completa) | Sí | No |
| Margen de error | Se puede calcular | No tiene sentido |
| Generalizar a la población | Sí, dentro del margen de error | Solo con supuestos fuertes y declarados |
| Costo y tiempo | Mayores | Menores |
| Usos típicos | Estadística oficial, encuestas de prevalencia, estudios con inferencia | Exploración, pruebas piloto, estudios cualitativos, grupos difíciles de encontrar, sondeos rápidos |
Ninguno es mejor en general. Una tasa de desempleo nacional, como las que publica el INEGI, necesita una muestra probabilística. Diez entrevistas con farmacéuticos de hospital sobre un nuevo sistema de pedidos necesitan una intencional. El error está en redactar una muestra no probabilística como si fuera probabilística.
Tipos de muestreo no probabilístico
Los manuales enumeran cuatro tipos principales (por conveniencia, intencional, por cuotas y bola de nieve), y las encuestas en línea volvieron común un quinto, el voluntario. De cada uno verás cómo funciona, un ejemplo en línea, cuándo sirve y qué sesgo vigilar.
Muestreo por conveniencia
El muestreo por conveniencia consiste en encuestar a quien tienes más a la mano: tus compañeros de carrera, los suscriptores de tu boletín, los visitantes de una página de tu sitio. También se le llama muestreo accidental.
Ejemplo: una estudiante de maestría en Guadalajara investiga los hábitos de sueño de universitarios. Comparte el enlace en tres grupos de WhatsApp de su propio programa y junta 180 respuestas en dos días.
Cuándo sirve: para la prueba piloto de un cuestionario, para explorar un tema antes de un estudio más grande o en un proyecto de clase. Riesgo principal: la muestra refleja tu propia red. Sus encuestados comparten carrera y horario, así que pueden dormir distinto que los de otras carreras.
Una variante más estricta es el muestreo consecutivo: incluyes a todas las personas que cumplen los criterios y llegan durante un periodo fijo, por ejemplo cada cliente que escribe a soporte en marzo o cada paciente que atiende una clínica en un mes. Así el investigador ya no elige a quién preguntar, pero el periodo y el lugar siguen decidiendo quién puede entrar.
Muestreo intencional o por juicio
En el muestreo intencional, también llamado por juicio, discrecional o de expertos, el investigador elige a propósito a las personas que tienen el conocimiento o la experiencia que el estudio necesita. Los criterios se escriben antes de reclutar.
Ejemplo: un equipo que evalúa un programa de desayunos escolares encuesta a los 12 directores y a los 25 responsables de cocina que lo operaron en su primer año, porque nadie más vio cómo funcionó en el día a día.
Cuándo sirve: paneles de expertos, entrevistas cualitativas, estudios de caso y encuestas a un grupo pequeño y conocido con una experiencia concreta. Hay variantes: casos típicos, casos extremos y máxima variación. Riesgo principal: el criterio del investigador. Si eliges solo a los directores a quienes les gustó el programa, se verá mejor de lo que fue. Escribe los criterios y aplícalos a todos los que los cumplen.
Muestreo por cuotas
El muestreo por cuotas fija una cantidad objetivo por grupo para que la muestra se parezca a la población en algunas características conocidas, como sexo, rango de edad o región. Dentro de cada grupo, la gente se sigue reclutando por conveniencia hasta llenar la cuota.
Ejemplo: una caja de ahorro regional sabe que el 55% de sus socios tiene entre 18 y 44 años y el 45% es mayor. Para 400 respuestas fija cuotas de 220 y 180 y cierra cada grupo cuando se llena.
Cuándo sirve: investigación de mercados, sondeos de opinión sin lista de contactos y tesis que necesitan una muestra parecida a la población en unas pocas variables clave. Riesgo principal: las cuotas solo ajustan la composición en las variables que fijas. Dentro de cada celda responden primero los más fáciles de contactar, que es justo lo que falló en 1948. Planea las metas con el planificador de cuotas y sigue el levantamiento con la calculadora de avance de cuotas.
Muestreo bola de nieve
En el muestreo bola de nieve los primeros participantes reclutan a los siguientes entre sus contactos, y la muestra crece por oleadas. Es el método habitual para grupos sin lista o que no le contestarían a un desconocido.
Ejemplo: una investigadora que estudia a intérpretes independientes de Lengua de Señas Mexicana empieza con seis intérpretes que conoce. Al final de la encuesta le pide a cada uno que reenvíe el enlace a sus colegas, y en tres oleadas llega a 140 personas.
El método tiene bases formales. Leo Goodman lo describió como procedimiento estadístico en un artículo de 1961 en The Annals of Mathematical Statistics, y Douglas Heckathorn desarrolló después el muestreo dirigido por los participantes (1997), que registra quién reclutó a quién y limita las invitaciones por persona para poder ajustar las estimaciones. Cuándo sirve: grupos raros u ocultos, temas sensibles, nichos profesionales. Riesgo principal: la gente recomienda a personas parecidas a ella, así que los más conectados quedan sobrerrepresentados y los aislados no aparecen. Pide que cada participante reenvíe el enlace en lugar de pasarte contactos ajenos: así no reúnes datos personales de terceros sin su consentimiento, algo que regula la LFPDPPP.
Muestreo voluntario o por autoselección
En el muestreo voluntario la encuesta está abierta y cada persona decide por su cuenta si participa: un enlace en redes sociales, una ventana emergente en un sitio, un sondeo abierto.
Ejemplo: un gobierno municipal publica en sus redes una encuesta sobre una nueva ciclovía y recibe 2,300 respuestas en una semana, sobre todo de ciclistas diarios y de personas que no quieren perder lugares de estacionamiento.
Cuándo sirve: para juntar ideas y quejas, medir interés o llegar a quien le importa un tema. Riesgo principal: responden más quienes tienen opiniones fuertes, y los enlaces abiertos atraen a encuestados que no son quienes dicen ser. En un experimento de 2022 de Pew Research Center con muestras en línea de inscripción voluntaria (opt-in), el 12% de los adultos menores de 30 años dijo tener licencia para operar un submarino nuclear, una licencia que prácticamente nadie tiene en Estados Unidos.
Según explicó Pew en un análisis de 2024, una causa probable son los encuestados falsos que responden sin sinceridad, y el problema se concentró en los adultos jóvenes. En una encuesta voluntaria, revisa las respuestas en busca de afirmaciones imposibles y presenta los resultados como la opinión de quienes decidieron responder.
¿Qué tipo de muestreo no probabilístico elegir?
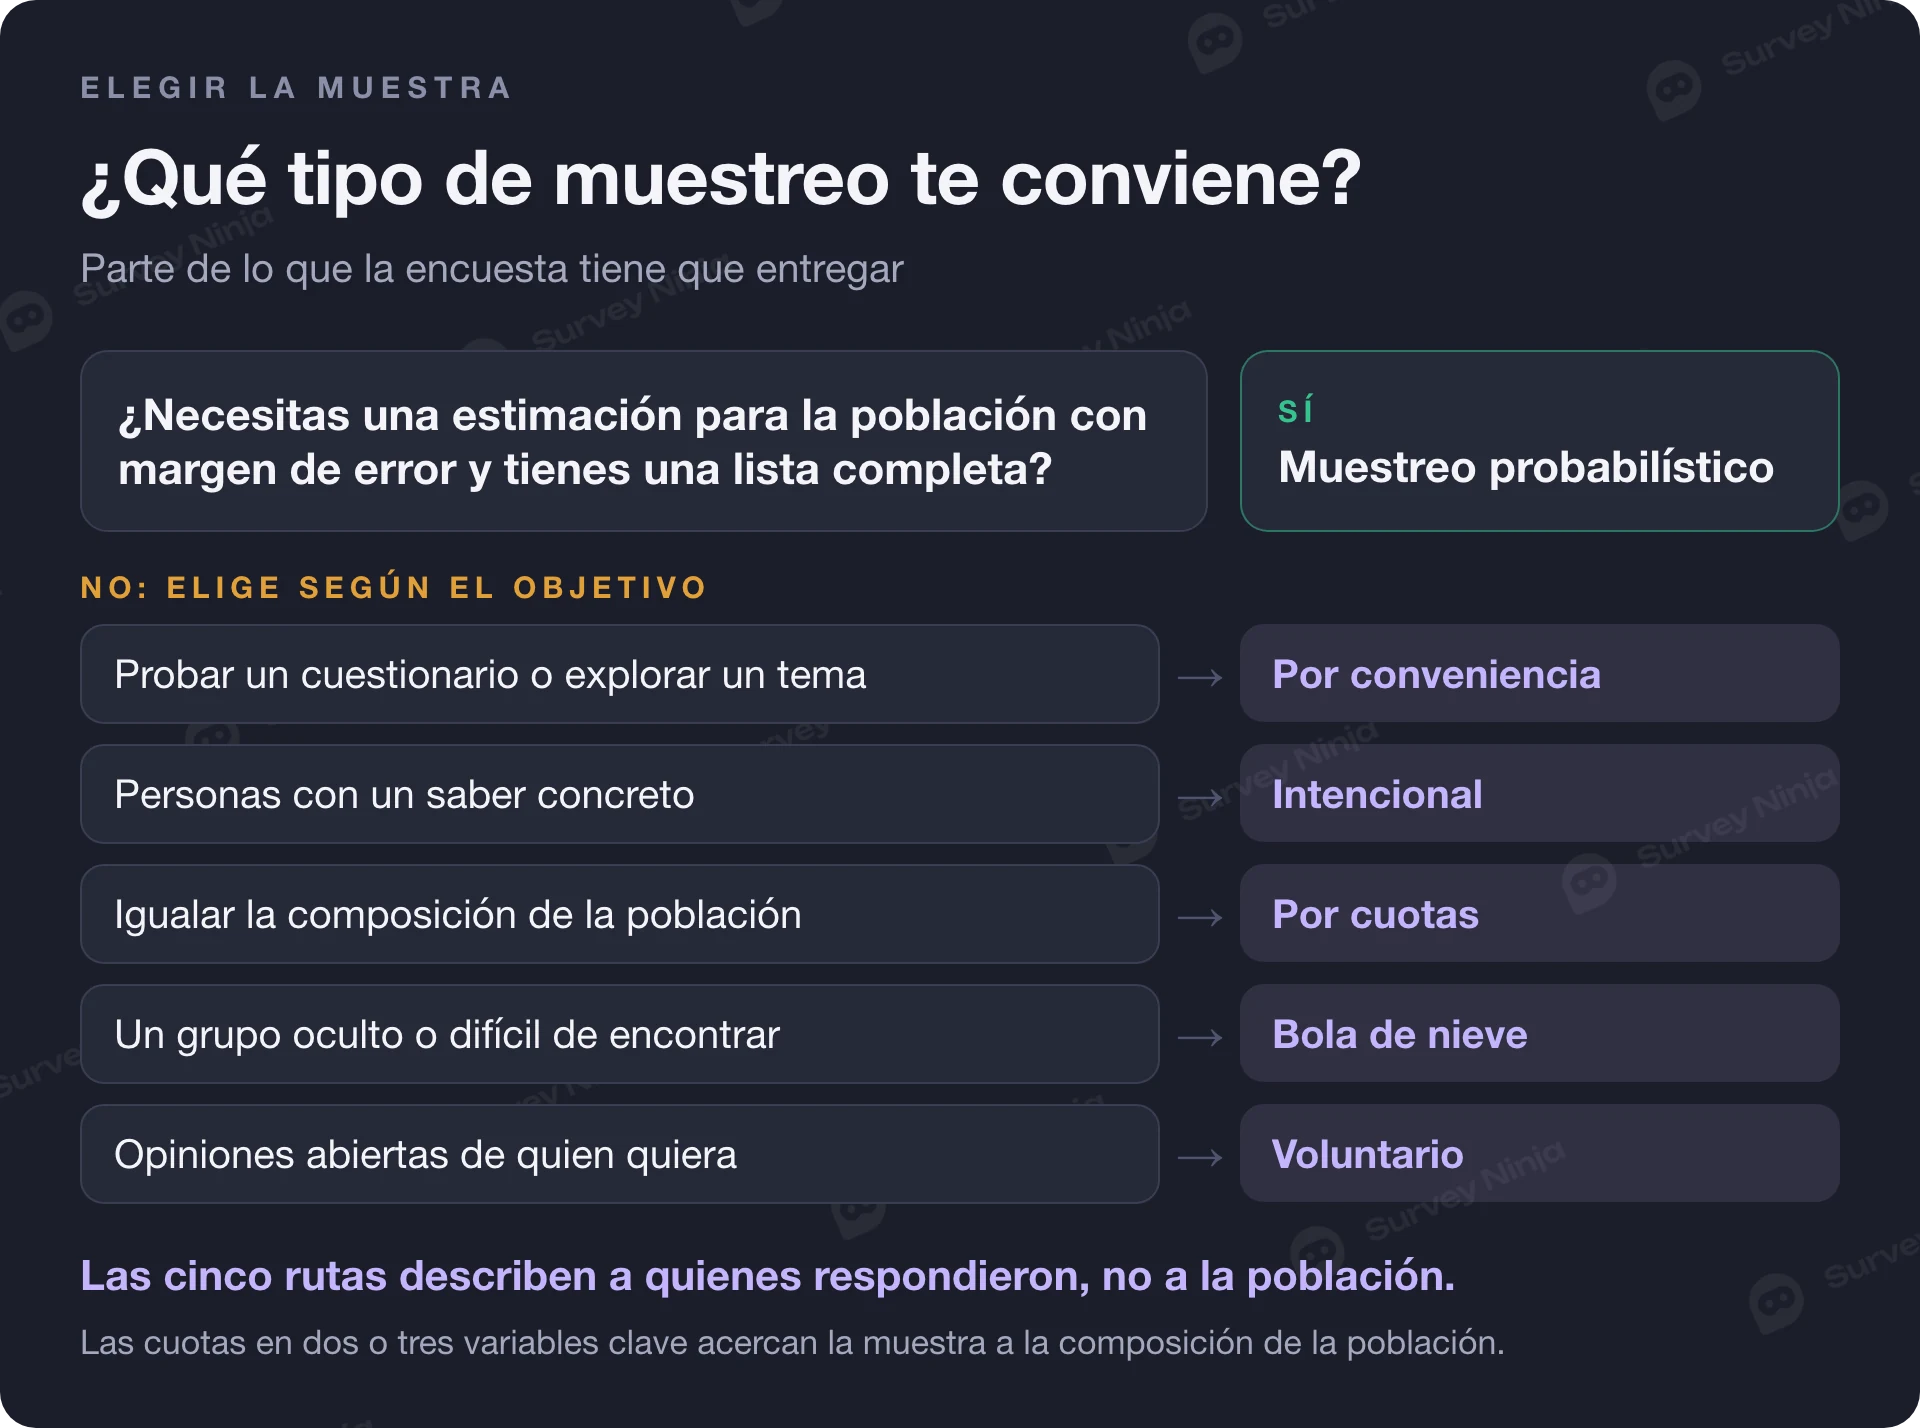
Elige el método a partir de tu pregunta de investigación y no de lo que sea más rápido. Si necesitas una estimación para toda la población con margen de error y tienes una lista, usa un diseño probabilístico. Si no, parte de tu objetivo: probar un cuestionario apunta a conveniencia, un saber concreto a intencional, la composición de la población a cuotas, un grupo oculto a bola de nieve y la opinión abierta a voluntario.
Ejemplo práctico: muestreo por conveniencia contra muestreo por cuotas
Una cuota en una sola variable clave puede mover una estimación varios puntos. Lo ilustramos con datos de ejemplo.
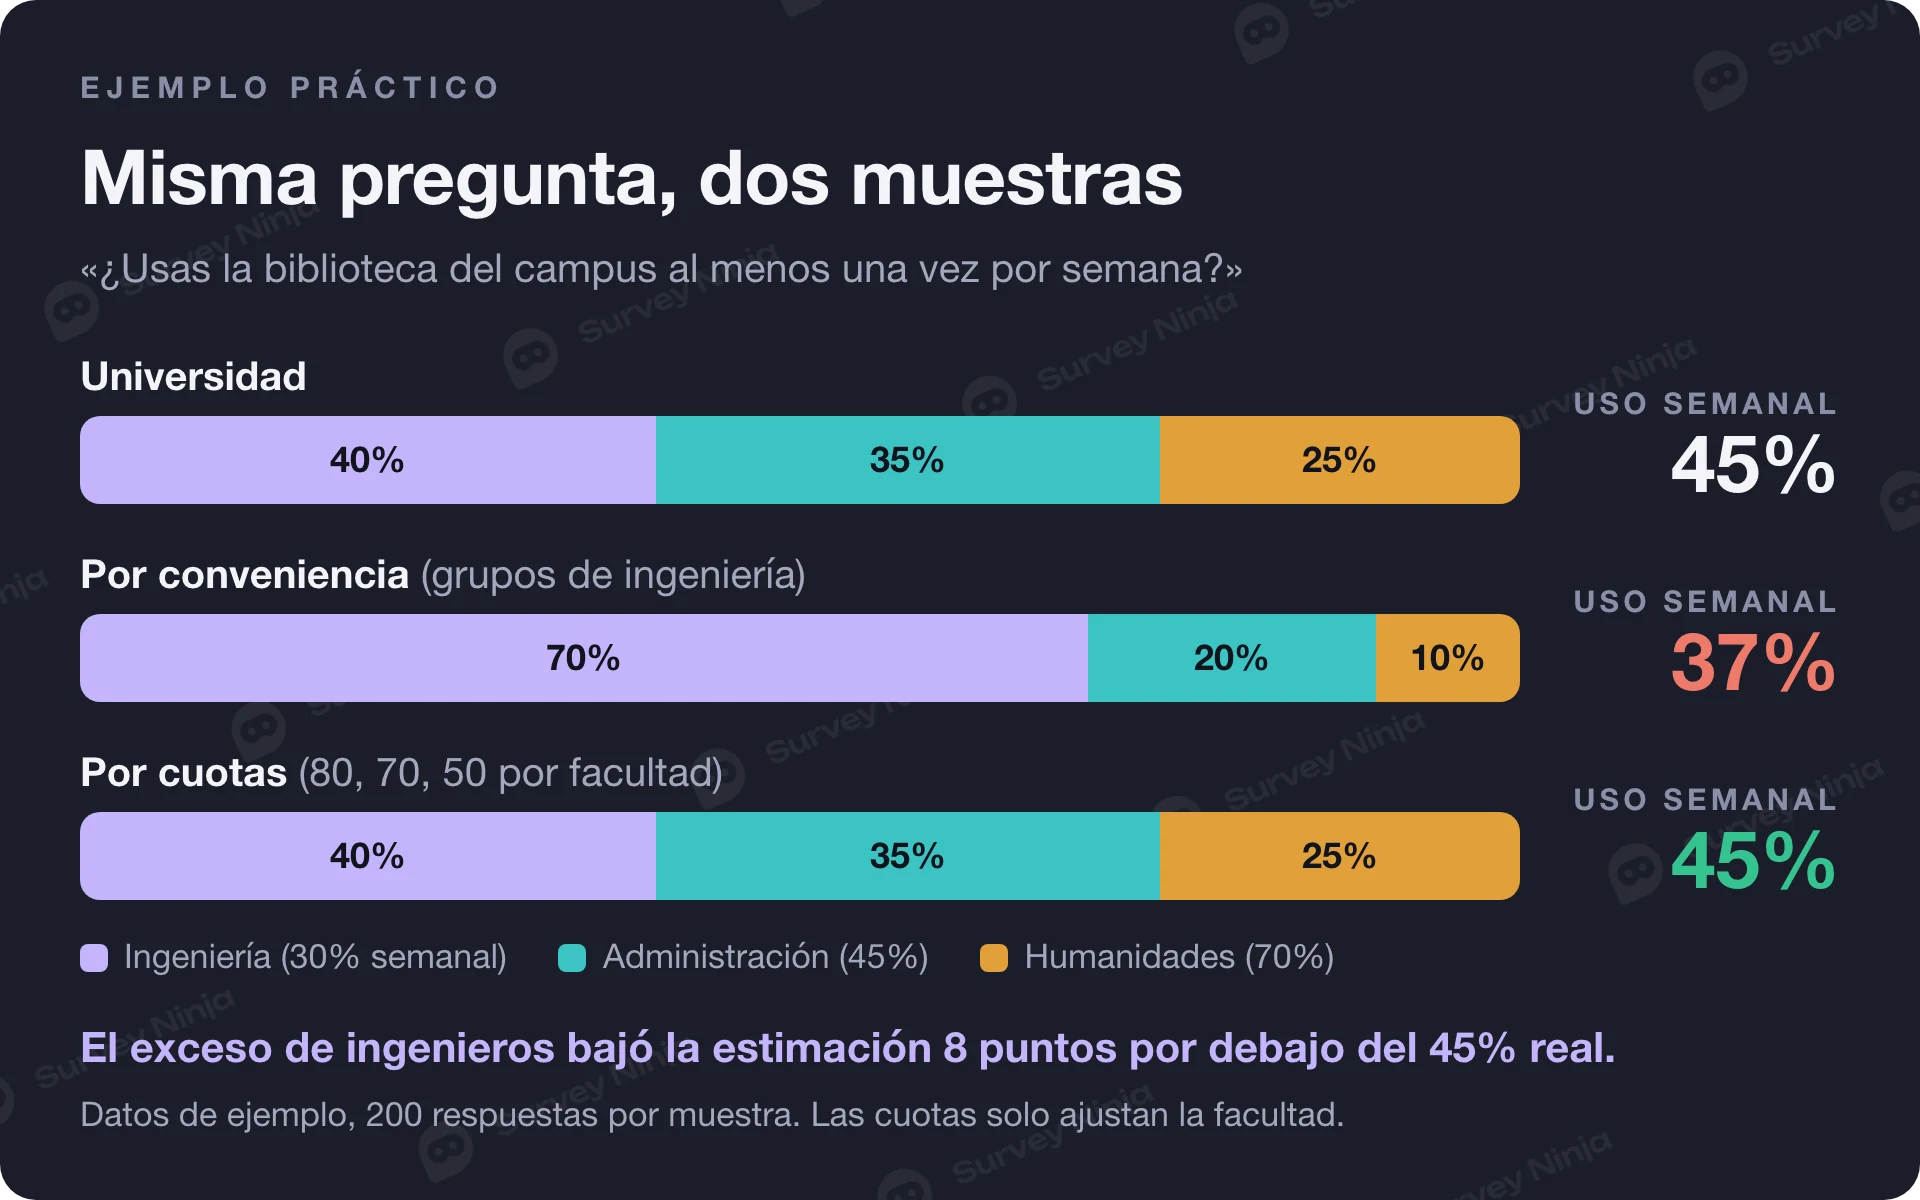
Una universidad tiene 8,000 estudiantes: 40% en ingeniería, 35% en administración y 25% en humanidades. Una tesista pregunta: «¿Usas la biblioteca del campus al menos una vez por semana?». Supongamos que el porcentaje real de uso semanal es 30% en ingeniería, 45% en administración y 70% en humanidades, lo que da cerca de 45% en toda la universidad.
La tesista junta 200 respuestas de dos formas: por conveniencia, con el enlace en sus grupos de ingeniería, y por cuotas según facultad, con 80, 70 y 50 respuestas. La tabla muestra qué parte de las respuestas aporta cada facultad y la estimación que da cada muestra.
| Facultad (% de alumnos) | Conveniencia | Cuotas |
|---|---|---|
| Ingeniería (40%) | 70% | 40% |
| Administración (35%) | 20% | 35% |
| Humanidades (25%) | 10% | 25% |
| Uso semanal estimado | 37% | 45% |
La muestra por conveniencia sobrerrepresenta a ingeniería, la facultad que menos usa la biblioteca, y reporta 37%: un error de 8 puntos que no bajaría con 2,000 respuestas de los mismos grupos. La muestra por cuotas respeta la composición por facultad y da 45%. En la muestra por conveniencia: (140 × 0.30 + 40 × 0.45 + 20 × 0.70) ÷ 200 = 37%.
El resultado por cuotas vale lo que vale su supuesto. Aquí acierta porque el ejemplo supone que quienes respondieron en cada facultad usan la biblioteca igual que su facultad completa. Pega el enlace en el tablero de avisos de la biblioteca y cada celda se llena de usuarios frecuentes. Por eso una muestra por cuotas sigue siendo no probabilística.
Qué puedes afirmar y qué no con una muestra no probabilística
Puedes describir a quienes respondieron, encontrar patrones y comparar grupos dentro de la muestra con cuidado. No puedes atribuir un margen de error a los resultados ni presentar porcentajes como hechos sobre la población. AAPOR sostiene desde hace años que reportar un margen de error muestral con muestras de autoselección es engañoso.
- Describe la muestra: «De los 212 estudiantes que respondieron, el 64% duerme menos de siete horas entre semana».
- Reporta patrones y diferencias dentro de la muestra, con el tamaño de cada grupo junto a cada porcentaje.
- Usa los resultados para plantear hipótesis que un estudio probabilístico pueda poner a prueba después.
- Compara tu muestra con datos conocidos de la población (edad, sexo, facultad) y señala dónde difiere.
- No escribas «el 64% de los universitarios duerme menos de siete horas».
- No reportes un margen de error ni «±5% con 95% de confianza» para toda la población.
- No llames representativa a la muestra solo porque es grande.
El tamaño de muestra sigue importando. Una calculadora de tamaño de muestra te dice cuántas respuestas necesita una muestra probabilística para cierta precisión, y muchos asesores piden que los estudios no probabilísticos lleguen a un número parecido. Preséntalo como meta y no como prueba de precisión. Ponderar la muestra hacia la población ayuda en las variables ponderadas y no corrige el sesgo en las demás.
Cómo redactar el muestreo no probabilístico en la metodología de tu tesis
El capítulo de metodología (el capítulo 3 en muchas tesis) debe permitir que el lector juzgue a quién representan tus encuestados. Según AAPOR, los estudios no probabilísticos exigen más transparencia que los probabilísticos, así que describe el reclutamiento con detalle. Nuestra guía para redactar la población y muestra de tu tesis cubre el apartado completo. El párrafo de muestreo debe incluir:
- La población objetivo (lugar, tiempo, criterios).
- El método de muestreo con su nombre y por qué se ajusta a la pregunta de investigación.
- Canales de reclutamiento, fechas, recordatorios e incentivos.
- Los criterios de inclusión y exclusión, y la pregunta filtro que los aplicó.
- Las cuotas planeadas y las alcanzadas, si usaste cuotas.
- Las respuestas válidas, cuántas se descartaron y por qué.
- Las limitaciones: qué grupos quedan probablemente sobre o subrepresentados.
Párrafo modelo para la metodología
«Se utilizó un muestreo no probabilístico por cuotas. La población objetivo fueron los estudiantes de licenciatura inscritos en [universidad] durante [semestre y año]. Las cuotas por facultad siguieron la matrícula oficial (ingeniería 40%, administración 35%, humanidades 25%). El cuestionario en línea se distribuyó del [fecha] al [fecha] por listas de correo de las facultades y grupos de WhatsApp, con un recordatorio a los siete días. Una pregunta filtro confirmó la inscripción vigente. De 236 respuestas recibidas, 200 estaban completas y fueron válidas. Como los participantes no se seleccionaron al azar, los resultados describen a los estudiantes que participaron y no se generalizan a toda la población estudiantil con un margen de error conocido.»
Nombra el método con precisión. Si compartiste un enlace y aceptaste a quien respondiera, la muestra es por conveniencia o voluntaria, no «aleatoria», sin importar cuántas personas contestaron. En la defensa, ese error sale caro.
Cómo reducir el sesgo en una muestra no probabilística
No puedes eliminar el sesgo de selección de una muestra no probabilística, pero sí reducirlo y hacerlo visible. Casi todo el trabajo ocurre antes de enviar el enlace.
- Define la población primero y luego elige canales que lleguen a ella.
- Usa varios canales: tres grupos o listas distintos traen más variedad que uno solo muy grande.
- Fija cuotas en dos o tres variables que conozcas para la población y que influyan en las respuestas, como rango de edad y región.
- Filtra al inicio, registra el origen de cada respuesta y compara la muestra final con datos conocidos de la población.
Los sesgos de redacción y de respuesta se suman al problema del muestreo. Nuestra guía de sesgos en encuestas los repasa con una lista de verificación por etapa.
Cómo levantar una encuesta no probabilística en SurveyNinja
Las cuotas y la lógica de descarte están en todos los planes, incluido el gratuito. Las cuotas fijan una meta por grupo, por ejemplo 80 estudiantes de ingeniería, 70 de administración y 50 de humanidades. La lógica de descarte termina la encuesta para quien no cumple los criterios de inclusión.
- Planea Calcula el total con la calculadora de tamaño de muestra y repártelo por grupos con el planificador de cuotas.
- Construye Crea la encuesta, agrega una pregunta filtro con lógica de descarte y una cuota por grupo.
- Etiqueta los canales Desde el plan Básico, agrega una variable oculta al enlace (por ejemplo ?source=whatsapp) para que cada respuesta registre de dónde vino.
- Da seguimiento Revisa el avance de las cuotas con la calculadora de avance y manda recordatorios a los canales que van atrasados.
- Exporta Descarga los datos en CSV, XLSX o SPSS en cualquier plan para tu análisis.
Preguntas frecuentes
¿Qué es el muestreo no probabilístico?
Es un método para seleccionar participantes en el que la participación depende del criterio del investigador, la facilidad de acceso, las recomendaciones o la autoselección, y no de un sorteo. Como la probabilidad de cada persona es desconocida, los resultados describen a quienes respondieron y no se generalizan con un margen de error.
¿Cuáles son los 4 tipos de muestreo no probabilístico?
Son el muestreo por conveniencia (personas fáciles de contactar), el intencional o por juicio (personas elegidas por su experiencia), el muestreo por cuotas (metas por grupo que se llenan sin sorteo) y el de bola de nieve (los participantes reclutan a otros). Muchas fuentes agregan el voluntario, en el que la gente decide responder una encuesta abierta.
¿Cuál es la diferencia entre muestreo probabilístico y no probabilístico?
En el muestreo probabilístico un proceso aleatorio elige a las personas de una lista, así que todas tienen una probabilidad conocida de ser seleccionadas y se puede calcular el margen de error. En el no probabilístico la selección depende del criterio, del acceso o de la autoselección, y esa probabilidad es desconocida. Sus resultados solo aplican a quienes respondieron.
¿Qué es el muestreo por conveniencia y cuándo se usa?
Es el muestreo en el que encuestas a las personas que tienes más a la mano, como tus compañeros o los seguidores de tu página. Se usa en pruebas piloto, proyectos de clase, estudios exploratorios y para reclutar entrevistados en investigación cualitativa. Permite reportar porcentajes de quienes respondieron, pero no estimaciones para toda la población con margen de error.
¿Se puede calcular el margen de error en una muestra no probabilística?
No en el sentido habitual. El margen de error estándar supone una muestra aleatoria de la población, y una muestra no probabilística no la tiene. AAPOR considera engañoso reportarlo en muestras de autoselección. En su lugar, informa el tamaño y la composición de la muestra, y presenta los resultados como hallazgos sobre los participantes.
¿Qué diferencia hay entre muestreo por cuotas y estratificado?
Los dos dividen la población en grupos, como rangos de edad o regiones, y fijan un número para cada grupo. El estratificado selecciona después a las personas al azar de una lista de cada grupo, así que es probabilístico. El de cuotas acepta a quien esté disponible hasta llenar cada cuota, así que sigue siendo no probabilístico.
Publicado: 18 nov. 2026