


Como escrever a seção de análise dos dados do TCC
Útil  Mike Taylor 30 set 2026 Tempo de leitura ≈ 13 min
A seção de análise dos dados diz à banca qual teste responde a cada pergunta do seu problema de pesquisa. Com a correspondência certa, ela cabe em meia página. Sem ela, os resultados ficam apoiados num teste que não responde ao que você perguntou.
A seção costuma fechar a metodologia, depois de população e amostra, dos instrumentos e do procedimento de coleta. Este guia mostra o que entra nela, como se calcula o Ranking Médio de um item Likert, qual teste corresponde a cada pergunta e como fica uma versão pronta.
O que é a seção de análise dos dados
É a lista dos testes estatísticos que você vai usar, com três informações sobre cada um: o que é, a qual pergunta do problema de pesquisa responde e como se calcula. Conforme a instituição, o título é Análise dos dados, Tratamento dos dados ou Procedimentos estatísticos. O conteúdo é o mesmo.
Mais duas coisas entram aqui. O nível de significância, quase sempre 0,05, declarado uma vez para todos os testes. E o programa, seja Excel, SPSS, R ou um gratuito como o JASP. O projeto usa o futuro ("será utilizado"), o TCC final o passado.
O jeito mais rápido de montar a seção é ler o problema de pesquisa pergunta por pergunta. Cada pergunta precisa de exatamente um teste, e cada teste listado precisa de uma pergunta. Um teste sem pergunta é enchimento, e a banca pode perguntar o que ele faz ali.
Ligue cada pergunta a um teste
As perguntas de pesquisa são de três tipos. Umas pedem para descrever algo, como o perfil dos respondentes ou o grau de concordância deles. Outras pedem para comparar grupos, como homens e mulheres. Outras perguntam se duas coisas estão relacionadas, como as horas de estudo e o desempenho. O tipo de pergunta decide o teste. O tipo de dado decide a variante.
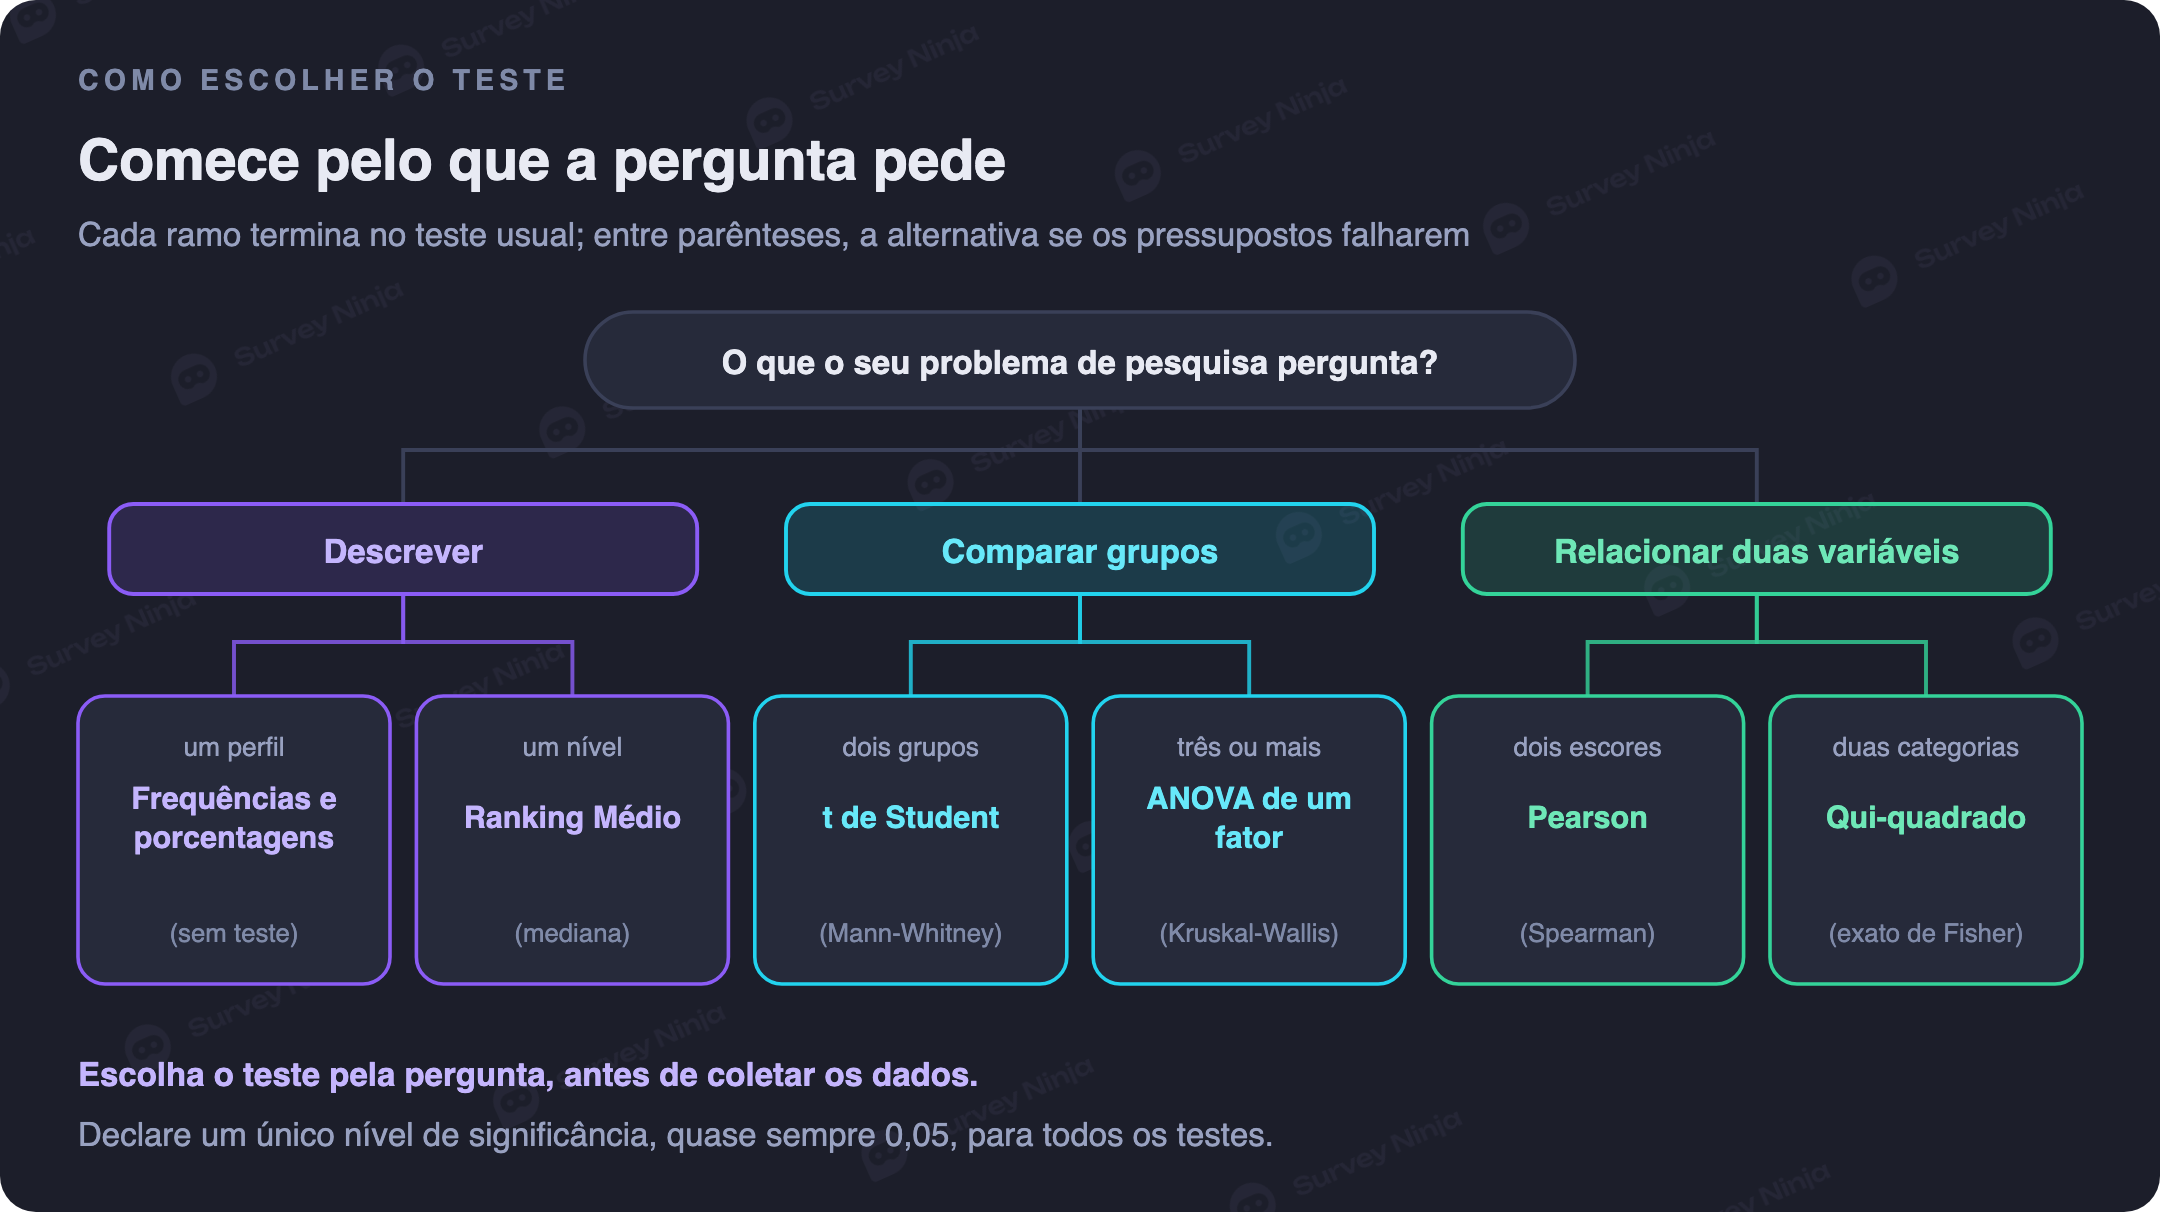
O mesmo mapa em tabela, com a alternativa para quando os pressupostos do teste não se sustentam:
| A pergunta pede | Exemplo | Teste usual | Se os pressupostos falharem |
|---|---|---|---|
| Um perfil | Qual é o perfil dos respondentes por sexo e curso? | Frequências e porcentagens | Não precisa |
| Um nível | Qual é o grau de concordância dos alunos com o ensino remoto? | Ranking Médio ou média com escala de interpretação | Mediana |
| Diferença, dois grupos | Há diferença significativa entre homens e mulheres? | t de Student para amostras independentes | Mann-Whitney |
| Diferença, três grupos ou mais | Há diferença entre Administração, Ciências Contábeis e Economia? | ANOVA de um fator | Kruskal-Wallis |
| Relação, dois escores | Há relação entre as horas de estudo e o grau de concordância? | Correlação de Pearson | Correlação de Spearman |
| Associação, duas categorias | O turno está associado à modalidade de estudo preferida? | Qui-quadrado de independência | Teste exato de Fisher, com frequências pequenas |
Frequências e porcentagens
A primeira pergunta de quase todo problema de pesquisa pede o perfil dos respondentes, e a ferramenta é a mais simples: contar cada categoria e transformar a contagem em proporção.
P = (f / n) × 100
Aqui f é a frequência de uma categoria e n o número de respondentes. Se 108 de 188 respondentes são mulheres, P = 108 / 188 × 100 = 57,4%. Arredonde para uma casa decimal e confira se cada variável soma 100,0. A tabela de perfil fica no capítulo de resultados.
Ranking Médio e escala de interpretação
Para perguntas sobre um grau de concordância medido com escala Likert, muitos TCCs usam o Ranking Médio (RM), na forma apresentada por Oliveira (2005). Cada resposta recebe um valor, de 5 para concordo totalmente a 1 para discordo totalmente, e o RM é a soma da frequência vezes o valor dividida pelo número de respondentes:
RM = Σ(fi × Vi) / NS
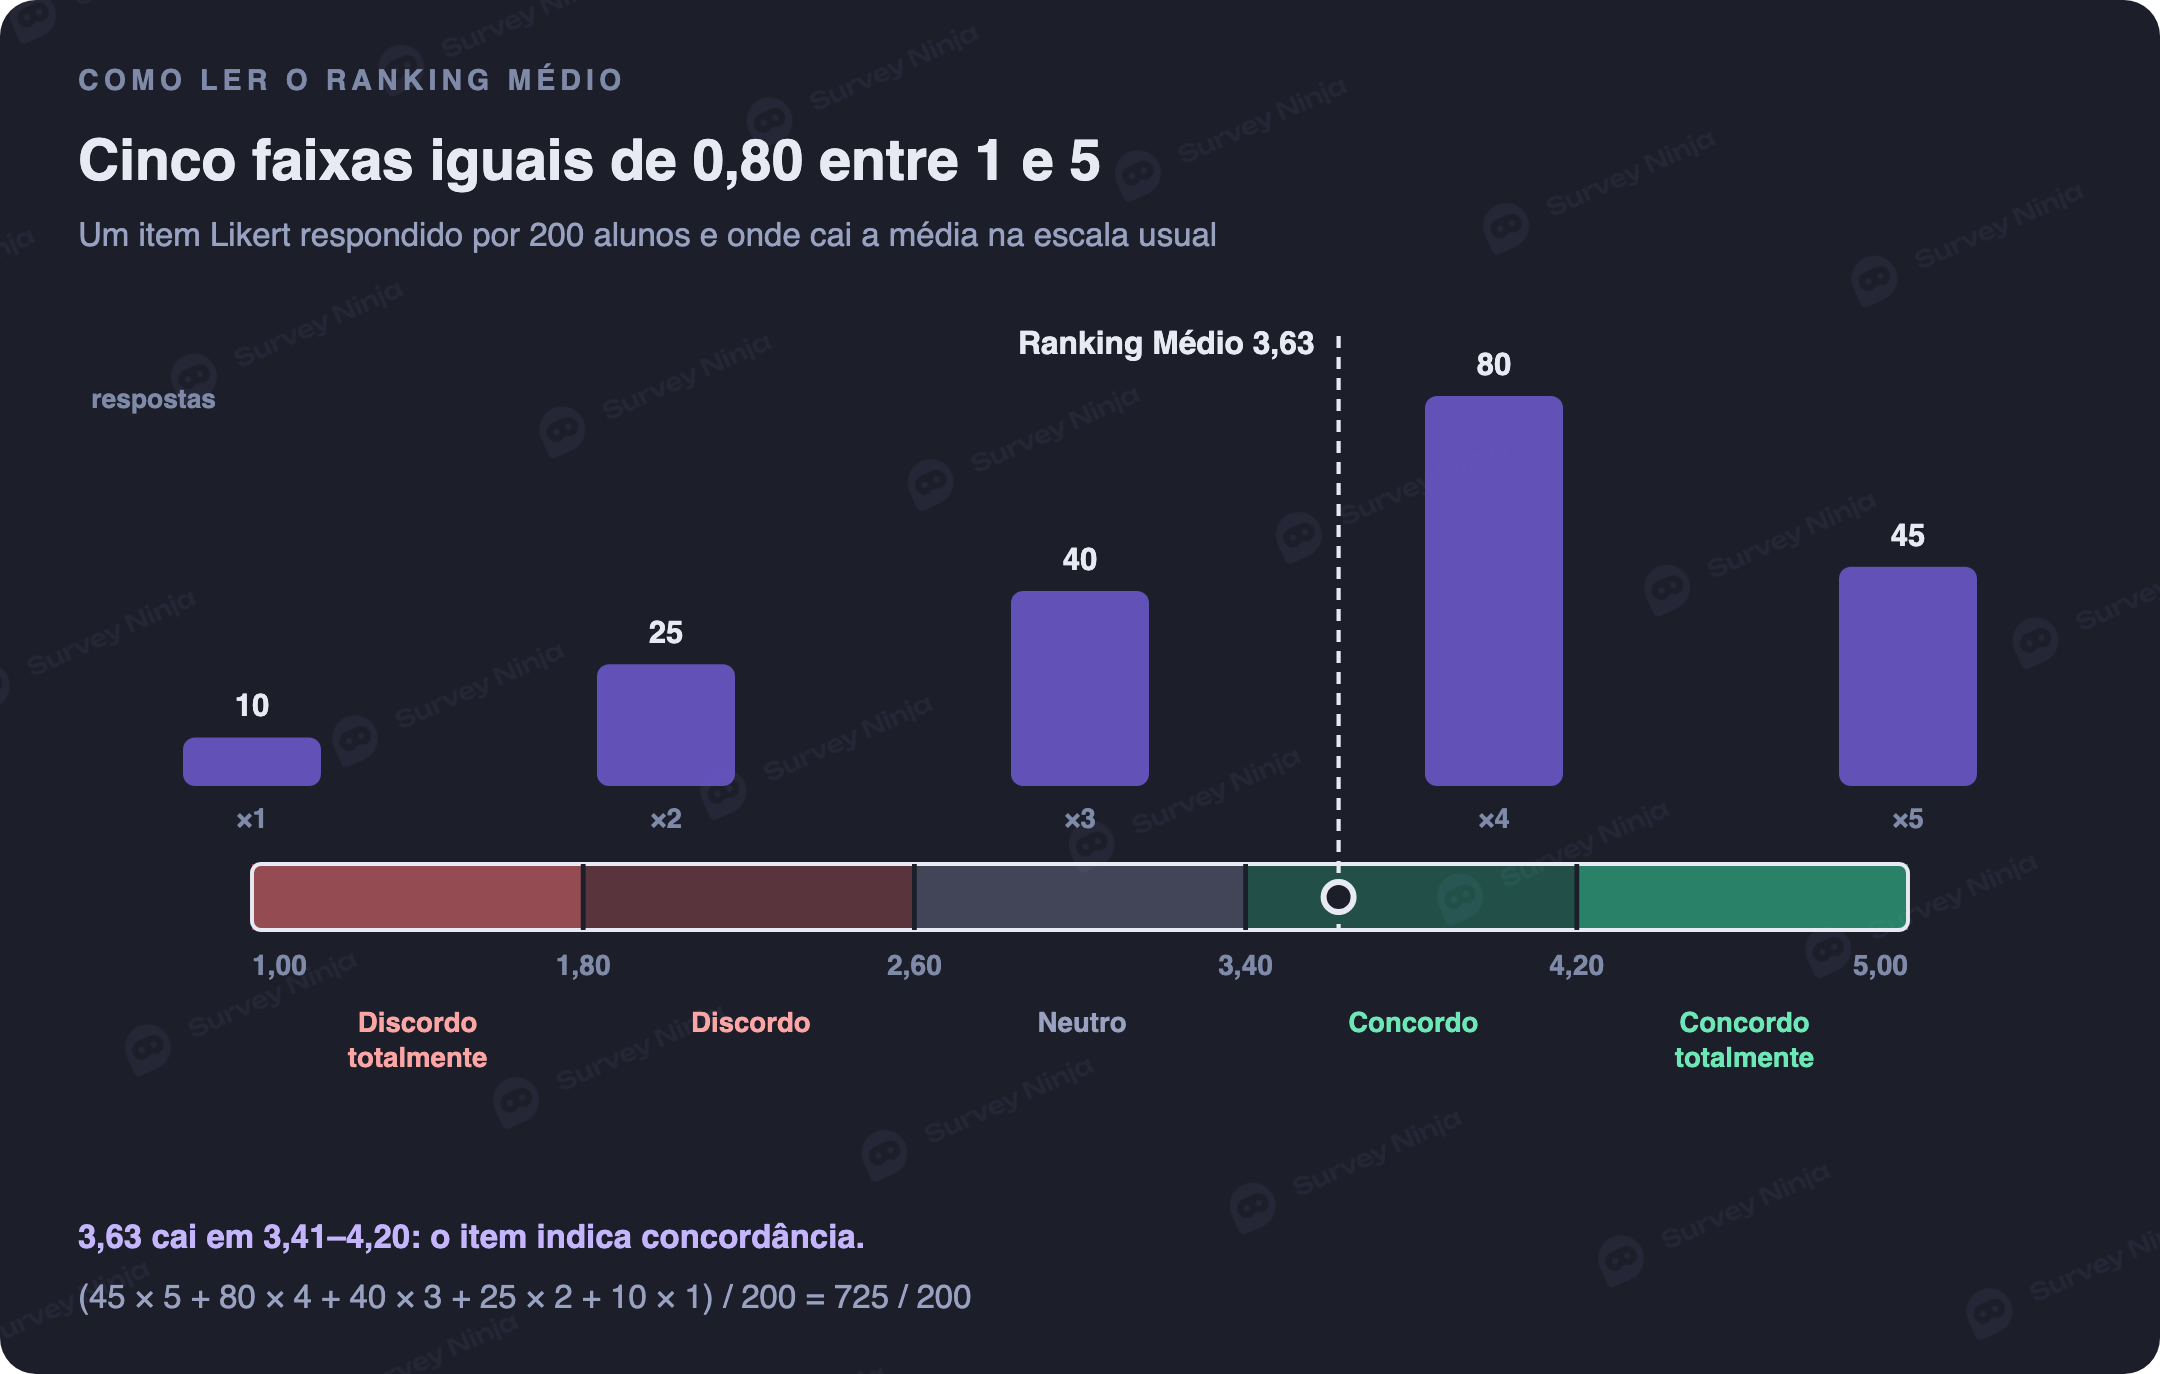
Um item respondido por 200 alunos: 45 concordo totalmente, 80 concordo, 40 neutro, 25 discordo e 10 discordo totalmente. O RM é (45 × 5 + 80 × 4 + 40 × 3 + 25 × 2 + 10 × 1) / 200 = 725 / 200 = 3,63. É a média comum das respostas codificadas, só que calculada a partir da tabela de frequências.
Na leitura clássica do RM, valores acima de 3 indicam concordância e abaixo de 3 discordância. Para uma leitura mais fina, a escala de interpretação usual corta a distância de 1 a 5 em cinco faixas iguais. A amplitude é 5 − 1 = 4. Dividida por cinco categorias, dá faixas de 0,80:
| Ranking Médio | Interpretação |
|---|---|
| 4,21–5,00 | Concordo totalmente |
| 3,41–4,20 | Concordo |
| 2,61–3,40 | Neutro |
| 1,81–2,60 | Discordo |
| 1,00–1,80 | Discordo totalmente |
Assim, 3,63 indica concordância nas duas leituras. Numa escala de 4 pontos a faixa é 3 / 4 = 0,75, com 1,00–1,75, 1,76–2,50, 2,51–3,25 e 3,26–4,00. Qualquer que seja a escala, diga de onde vêm as faixas. Uma tabela de intervalos sem explicação é um alvo fácil para a banca.
Tenha em mente o que o RM não faz: ele descreve, não testa. "O grau de concordância é alto" é uma descrição. "Homens e mulheres diferem" é uma afirmação que precisa de teste. Quando as respostas se acumulam nos dois extremos, uma média de 3 esconde uma divisão, e o nosso guia de análise descritiva mostra quando a mediana conta melhor a história. Se o questionário ainda está sendo montado, o guia da escala Likert cobre rótulos, número de pontos e itens invertidos.
Dá para usar t de Student com dados Likert?
Uma leitura estrita diz que não. Respostas Likert são ordinais, a distância entre concordo e concordo totalmente não é conhecida, então média e testes paramétricos não deveriam se aplicar. Na prática a questão foi resolvida de outro jeito. Norman (2010), na Advances in Health Sciences Education, revisou estudos desde os anos 1930 e mostrou que o t de Student, a ANOVA e a correlação de Pearson são robustos a essas violações: com dados Likert, raramente dão a resposta errada.
Daí sai uma regra prática. Quando você soma ou tira a média de vários itens num escore por respondente, os testes paramétricos servem. Quando testa um item isolado, ou os escores são claramente assimétricos, use a alternativa da tabela. Para verificar a distribuição, o teste de Shapiro-Wilk é a escolha usual, e Razali e Wah (2011) mostraram que ele é o mais potente entre os testes de normalidade comuns. Seja qual for a regra, escreva-a antes de ver os resultados.
Diferenças: t de Student e ANOVA
O t de Student para amostras independentes compara as médias de dois grupos, como homens e mulheres. Com três grupos ou mais, como três cursos, use uma ANOVA de um fator em vez de vários testes t, porque cada teste extra aumenta a chance de um falso positivo. Se a ANOVA encontrar diferença significativa, um teste post hoc como o de Tukey mostra quais grupos diferem.
Essas perguntas costumam ser escritas como hipótese nula: "Não há diferença significativa no grau de concordância entre homens e mulheres". A regra de decisão também entra na seção. Se o valor-p for menor que 0,05, rejeita-se a hipótese nula. O nosso verbete do glossário sobre significância estatística explica o que o valor-p diz e o que não diz.
Relações: Pearson, Spearman e qui-quadrado
A correlação de Pearson mede a relação linear entre dois escores, de −1 a +1. Cohen (1988) propôs 0,10, 0,30 e 0,50 como efeito pequeno, médio e grande, e o TCC informa o coeficiente junto com o valor-p. Quando os escores não seguem distribuição normal, ou são ordinais, usa-se a correlação de Spearman. A nossa calculadora de correlação de Pearson devolve r, r² e o valor-p a partir de duas colunas de dados. O nosso guia de correlação em pesquisas explica por que nem um r significativo mostra que uma coisa causa a outra.
Quando as duas variáveis são categorias, como turno e modalidade preferida, o teste é o qui-quadrado de independência. Ele compara as frequências observadas numa tabela cruzada com as que se esperariam se as variáveis não tivessem relação. A regra prática pede frequência esperada de pelo menos 5 na maioria das células. Com menos, use o teste exato de Fisher. A nossa calculadora de qui-quadrado aceita tabelas 2×2 e maiores.
Confiabilidade, nível de significância e programa
Se o instrumento é um conjunto de itens Likert, a banca também vai perguntar se ele é confiável. Isso costuma ser informado na seção do instrumento, a partir do pré-teste, com o alfa de Cronbach. Alguns modelos pedem que se repita aqui. Siga o modelo da sua instituição.
Declare o nível de significância uma vez: "Todos os testes usarão nível de significância de 0,05". Informe o programa e a versão. O Excel com o suplemento Ferramentas de Análise cobre frequências, médias, teste t, ANOVA de um fator e correlação. Os gratuitos JASP e jamovi acrescentam testes post hoc, testes não paramétricos e Shapiro-Wilk em poucos cliques.
Os dados podem vir direto do questionário. Você monta a pesquisa de graça no SurveyNinja e exporta as respostas para o Excel, uma coluna por pergunta, prontas para codificar.
Um modelo de seção de análise dos dados
Este é um exemplo completo para um estudo descritivo correlacional, escrito para o projeto de pesquisa. Troque os dados entre colchetes e mantenha um teste por pergunta.
Os dados serão tabulados e analisados no Microsoft Excel e no JASP [versão], com nível de significância de 0,05 para todos os testes.
1. Frequências e porcentagens serão usadas para descrever o perfil dos respondentes por sexo e curso, com P = (f / n) × 100.
2. O grau de concordância com cada item será calculado pelo Ranking Médio, RM = Σ(fi × Vi) / NS, e interpretado pela escala: 4,21–5,00 concordo totalmente, 3,41–4,20 concordo, 2,61–3,40 neutro, 1,81–2,60 discordo e 1,00–1,80 discordo totalmente.
3. A normalidade dos escores será verificada pelo teste de Shapiro-Wilk. A diferença entre homens e mulheres será testada pelo t de Student para amostras independentes ou, sem normalidade, pelo teste de Mann-Whitney.
4. A relação entre as horas semanais de estudo e o grau de concordância será medida pela correlação de Pearson ou, sem normalidade, pela de Spearman.
No TCC final, o mesmo texto passa para o passado e informa a versão do programa que de fato foi usada.
Erros comuns na análise dos dados
- Um teste listado sem nenhuma pergunta do problema para responder.
- O Ranking Médio usado para afirmar uma diferença significativa. Ele descreve, não testa.
- Vários testes t onde era preciso uma ANOVA.
- Pearson usado com duas categorias, ou qui-quadrado com dois escores.
- Uma escala de interpretação sem dizer de onde vêm as faixas.
- "Significativo" escrito sem valor-p nem nível de significância.
- Fórmulas copiadas sem explicar o que significa cada símbolo.
A análise dos dados é a última promessa da metodologia. O capítulo de resultados cumpre essa promessa, pergunta por pergunta, na mesma ordem.
Perguntas frequentes
O que é a seção de análise dos dados do TCC?
É a parte da metodologia que nomeia cada teste estatístico do estudo, a pergunta de pesquisa que ele responde, a fórmula e o nível de significância, quase sempre 0,05.
Como escrever a análise dos dados?
Percorra o problema de pesquisa pergunta por pergunta e atribua um teste a cada uma: frequências e porcentagens para o perfil, Ranking Médio para o grau de concordância, t de Student ou ANOVA para diferenças, Pearson, Spearman ou qui-quadrado para relações. Depois acrescente o nível de significância e o programa.
Como calcular o Ranking Médio?
RM = Σ(fi × Vi) / NS, onde fi é o número de respondentes que escolheu uma resposta, Vi o valor dela, de 5 para concordo totalmente a 1 para discordo totalmente, e NS o total de respondentes. Acima de 3 indica concordância, abaixo de 3 discordância.
O que significa um Ranking Médio de 3,41 a 4,20?
Na escala de interpretação usual de 5 pontos significa concordo. A escala divide a amplitude de 1 a 5 em cinco faixas iguais de 0,80, então 4,21 a 5,00 é concordo totalmente e 3,41 a 4,20 é concordo.
t de Student ou ANOVA?
t de Student para dois grupos, ANOVA de um fator para três ou mais. Fazer vários testes t em vez de uma ANOVA aumenta a chance de um falso positivo.
Pearson ou Spearman?
Pearson quando os dois escores são numéricos e seguem distribuição aproximadamente normal. Spearman quando são ordinais, assimétricos ou a relação não é linear, mas é sempre crescente ou sempre decrescente.
Publicado: 30 set 2026